
 1,363
 578
大模型:PSI Agent 的认知大脑
我们希望大模型成为 PSI Agent 连接感知、语言、推理与决策的认知核心。目前重点推进其中两项基础能力:高效多模态推理,以及在三维空间中的空间智能体。
More coming soon
我们正在探索多智能体进化与桌面智能体。
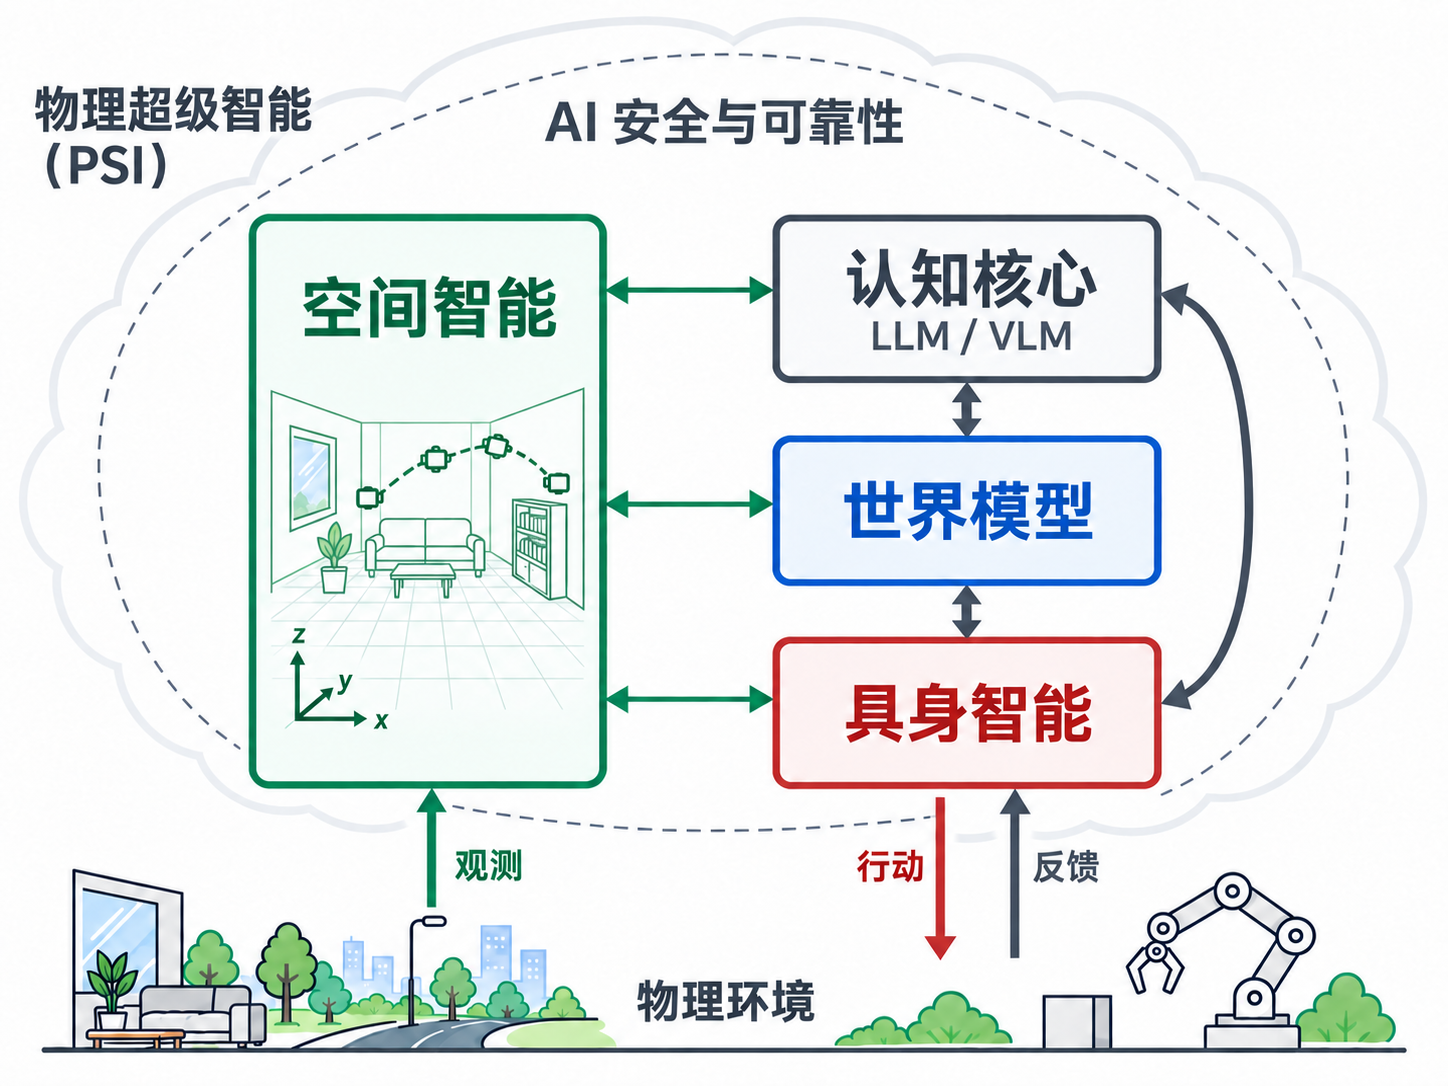
大模型为通用智能提供了重要基础,但要实现现实世界的物理超级智能(PSI),还需要围绕它建立完整的物理世界支撑系统。 在大模型认知、推理与决策能力的基础上,我们将空间智能、世界模型与具身智能连接为一个持续感知、预测、行动和反馈的智能系统,并研究贯穿其中的效率与安全问题。
欢迎对这个方向感兴趣的合作者加入我们(可邮件联系wenzhao.zheng@outlook.com)。
本页仅展示由本人担任主要作者(第一作者/共同第一作者/Project Leader/通讯作者)的工作。
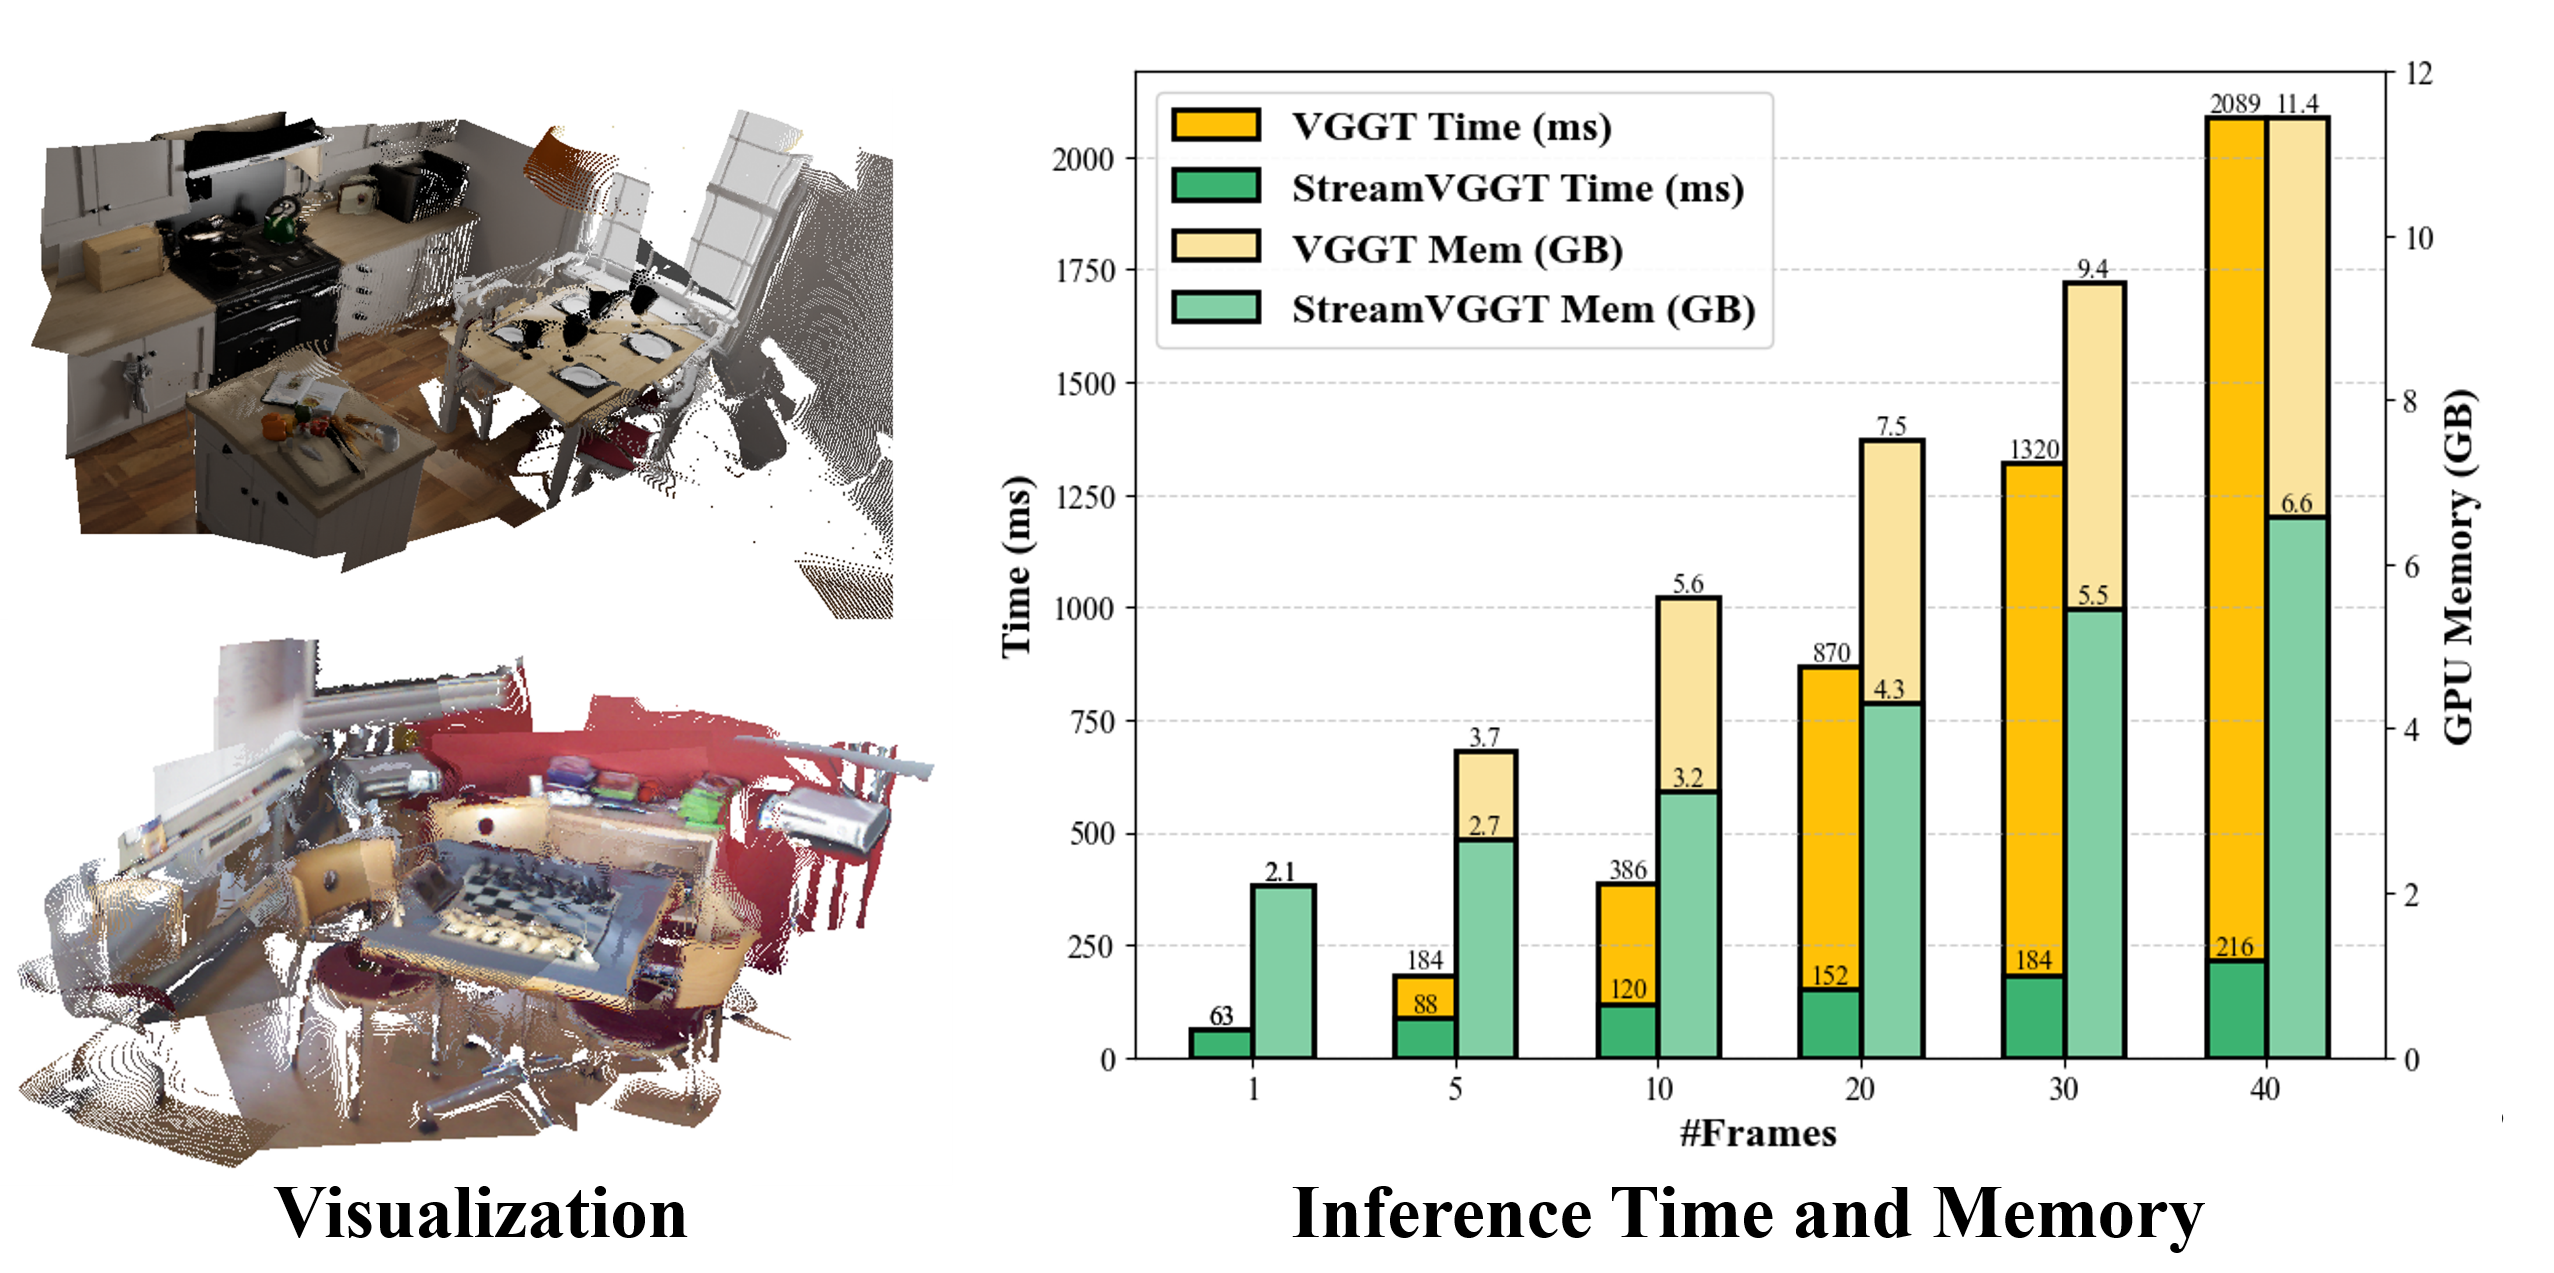
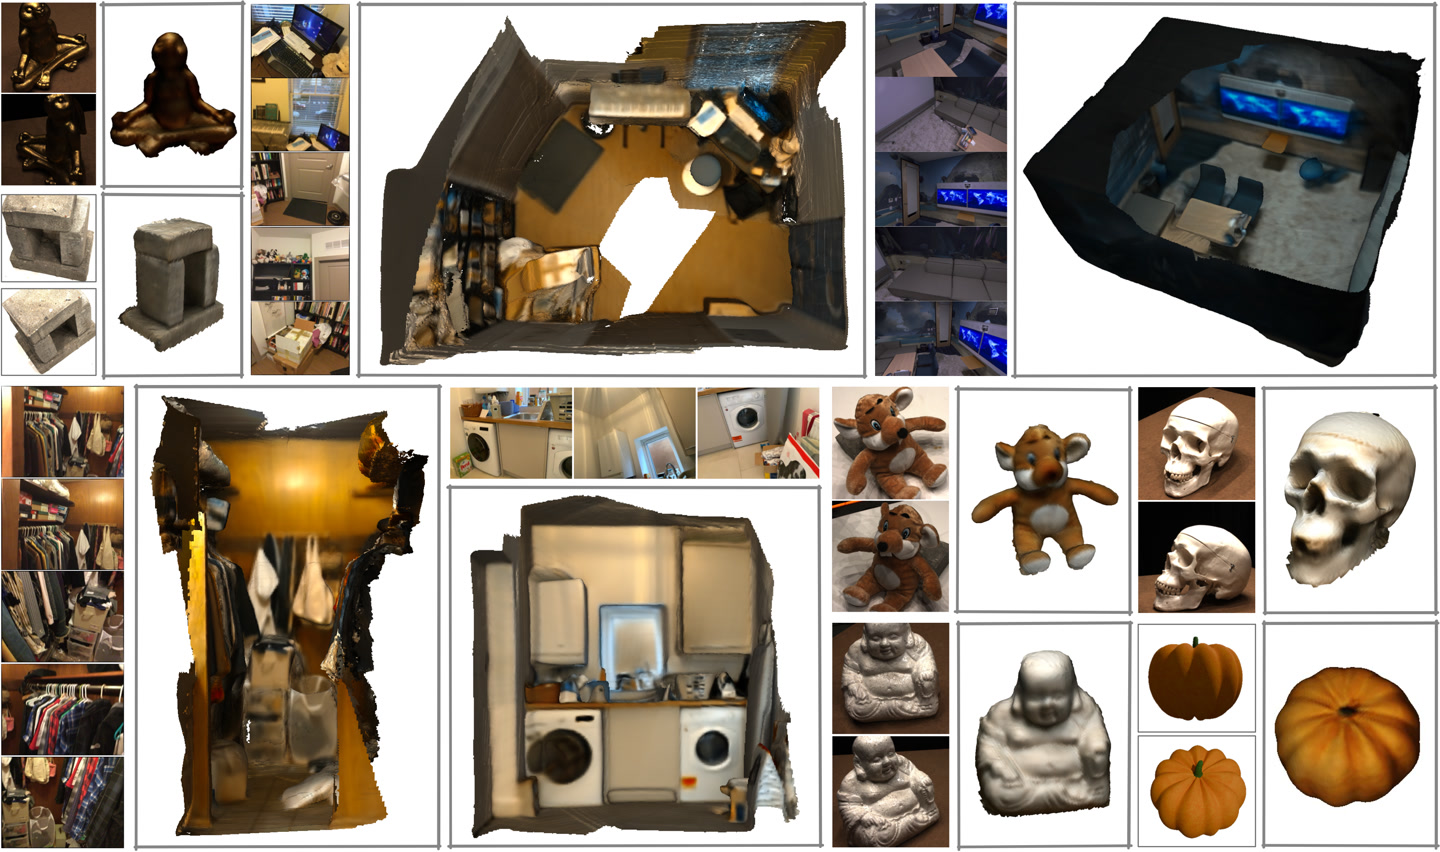
空间智能是物理超级智能(PSI)的基础,提供基本空间理解、仿真训练数据等。我们从图像和视频中恢复场景的几何、语义与运动,并研究更高效、完备的三维世界表征。过去的工作包括三维语义占用预测、前馈式高斯预测与流式三维重建。现在我们关注:
视频加载失败,可通过下方项目链接查看原始演示。
视频加载失败,可通过下方项目链接查看原始演示。
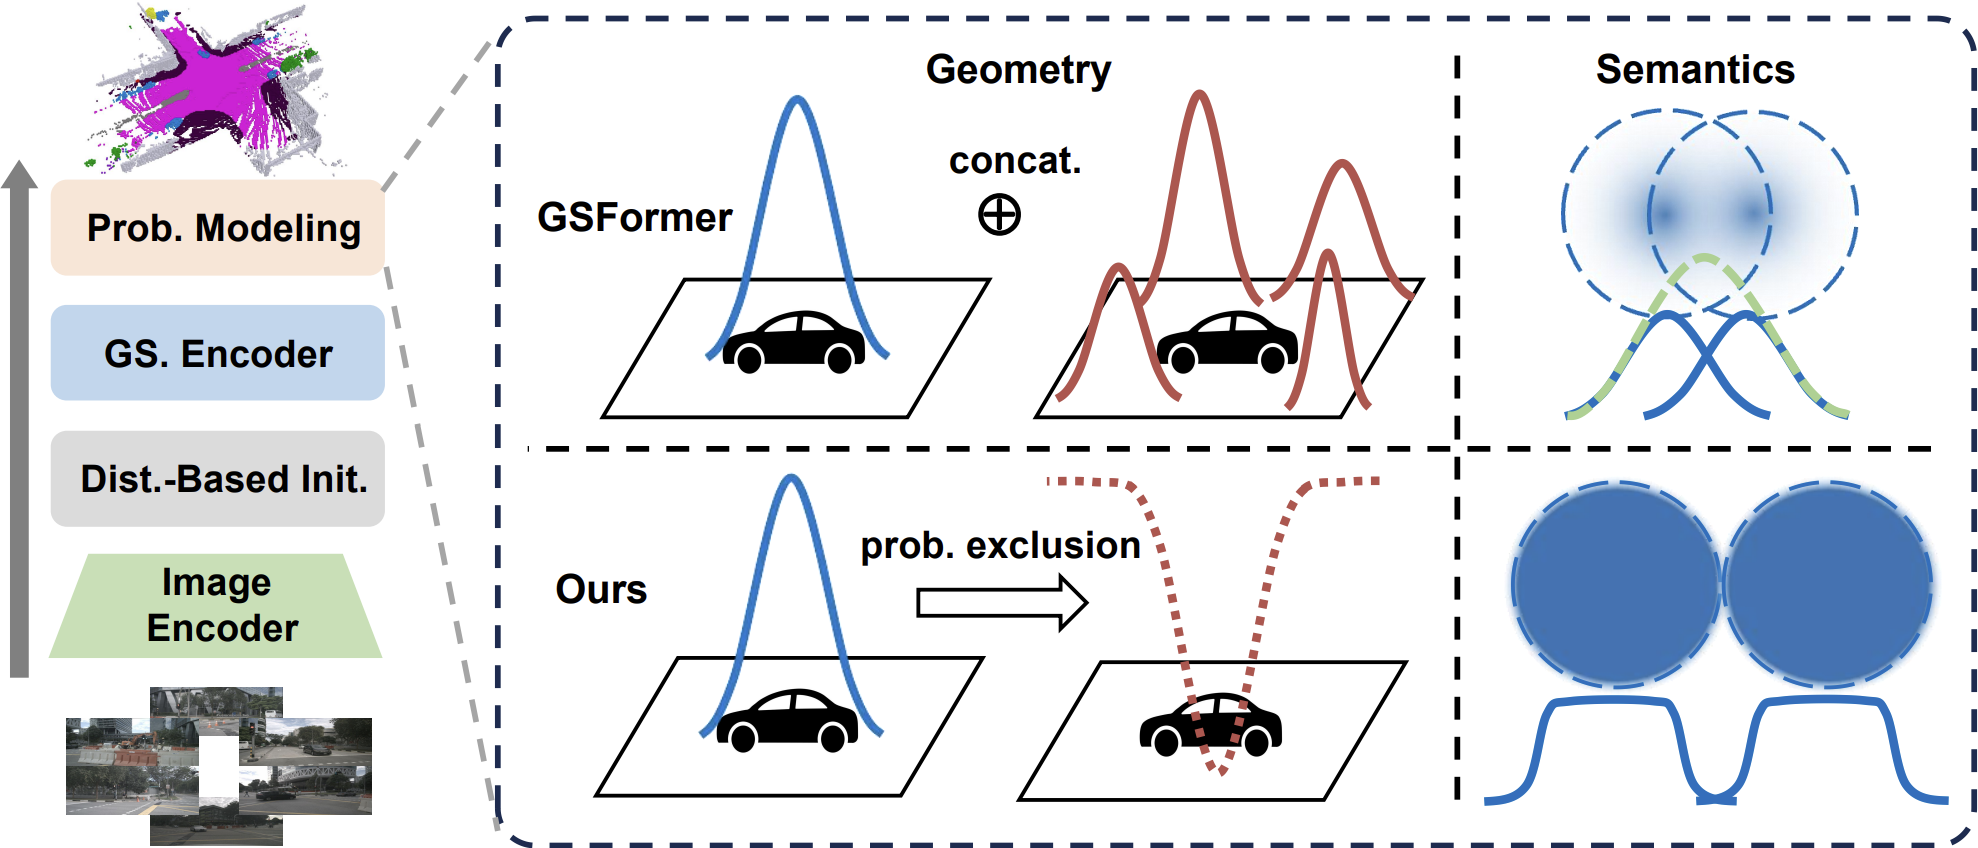
我们并不把表征的发展理解为简单的替代关系。深度、占据、点、高斯和隐式场各有取舍。我们更关心:如何保留智能体预测与行动所需的几何、运动和不确定性信息。
待研究的问题 如何同时表示连续表面与结构化运动,并保持仿真与在线交互所需的效率?
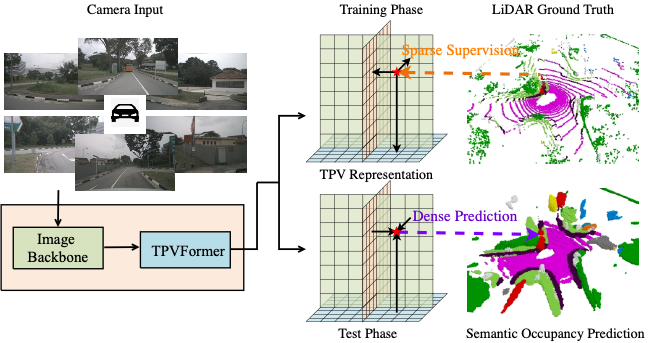
显式描述场景几何与语义,同时降低监督成本。
提出三视角表示,从相机图像预测三维语义占据,让场景理解超越单一鸟瞰平面的表达。
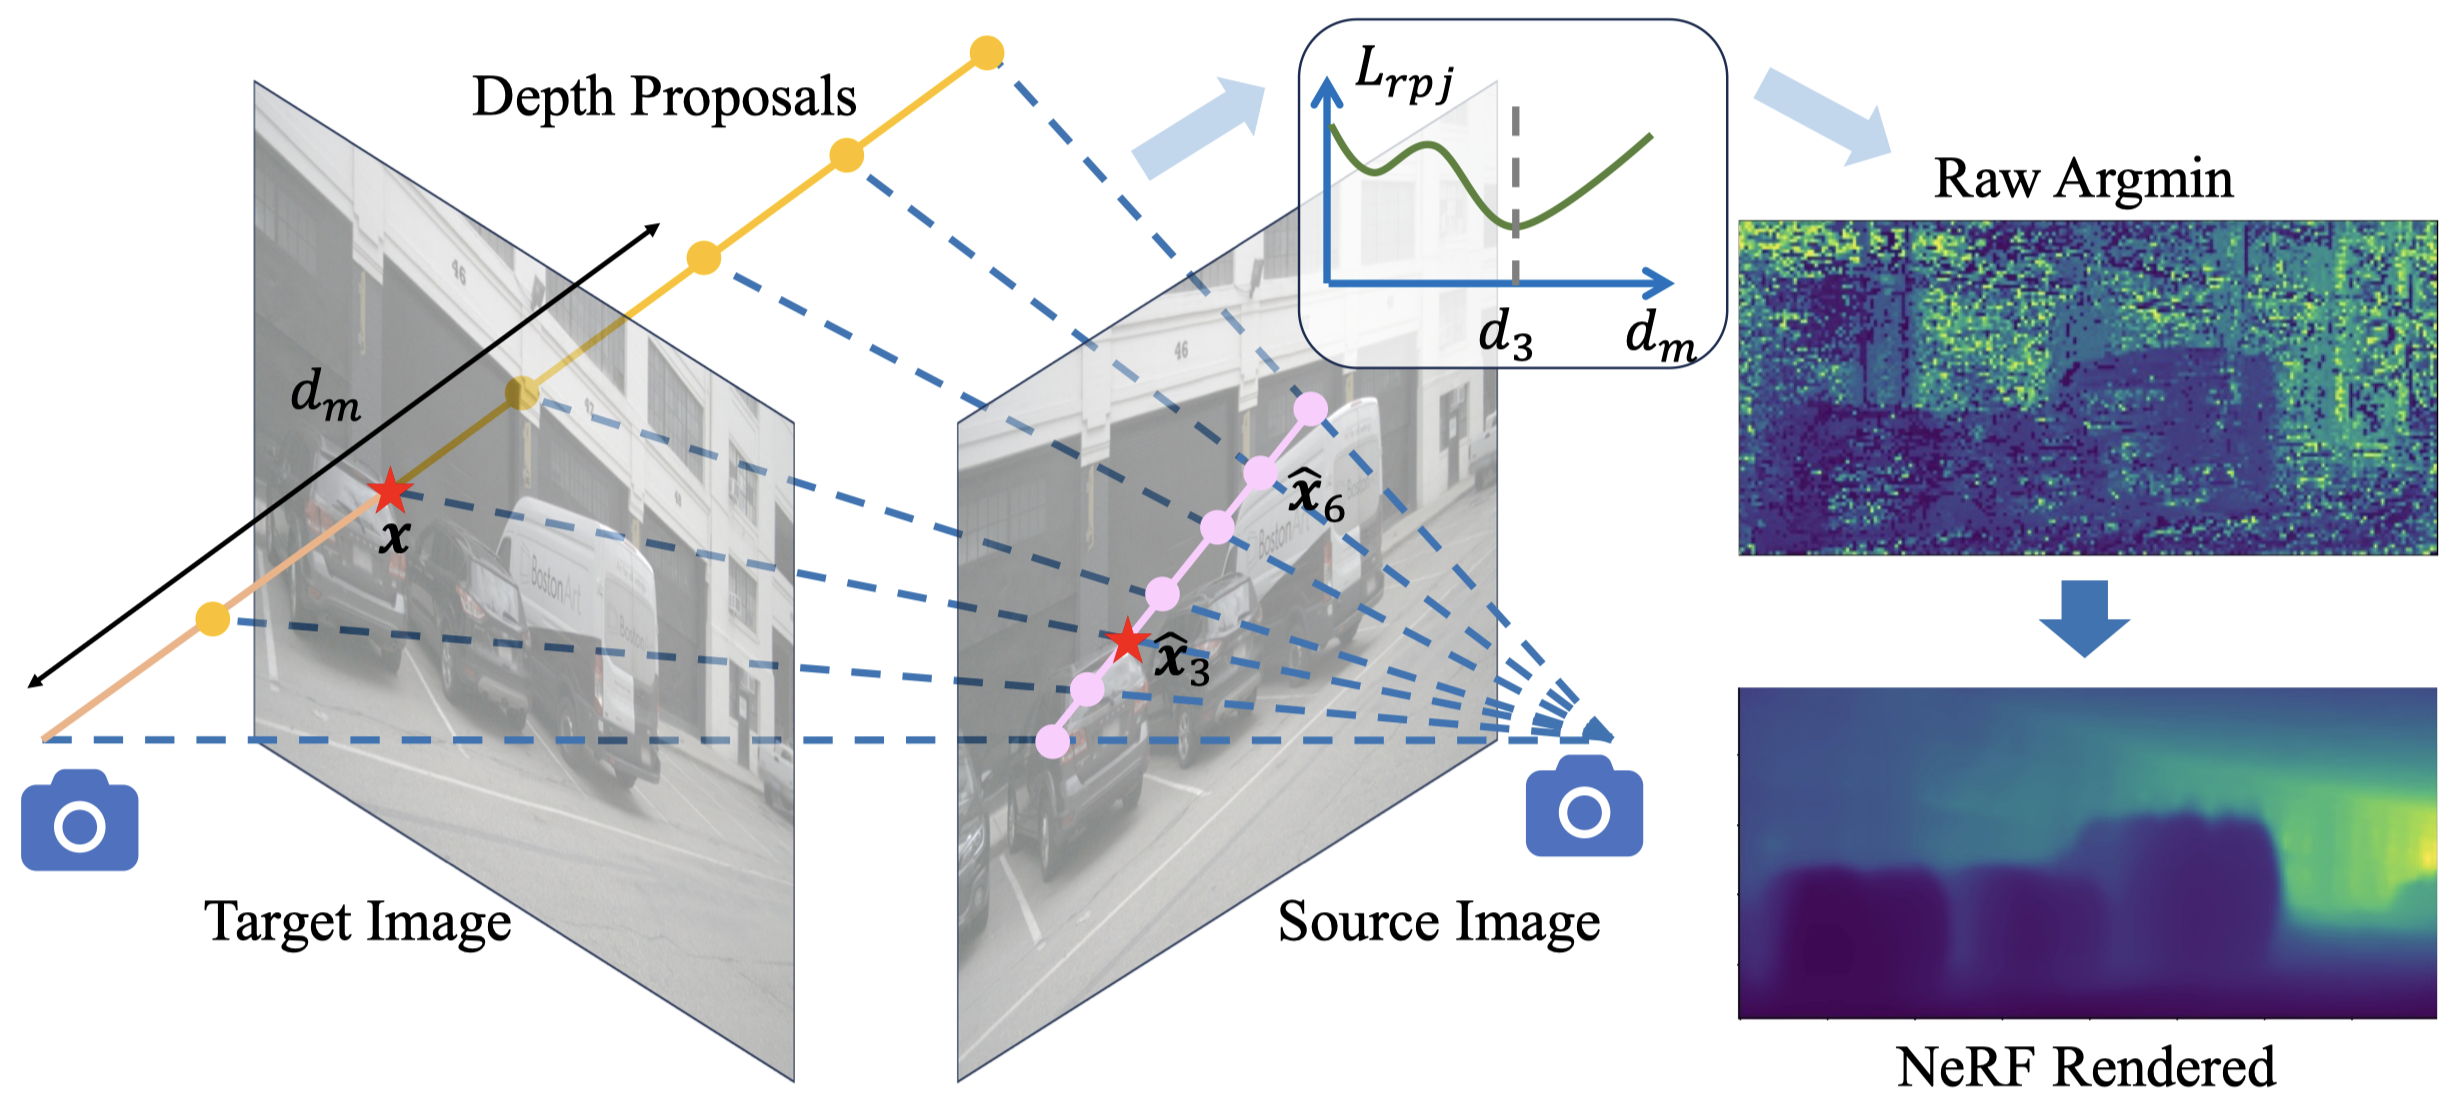
利用符号距离场与时序图像渲染,从视频监督中学习场景几何,减少对三维占用标注的依赖。
通过柱坐标三视角特征,从激光雷达点云恢复语义占用,在三维覆盖范围与计算成本之间取得平衡。
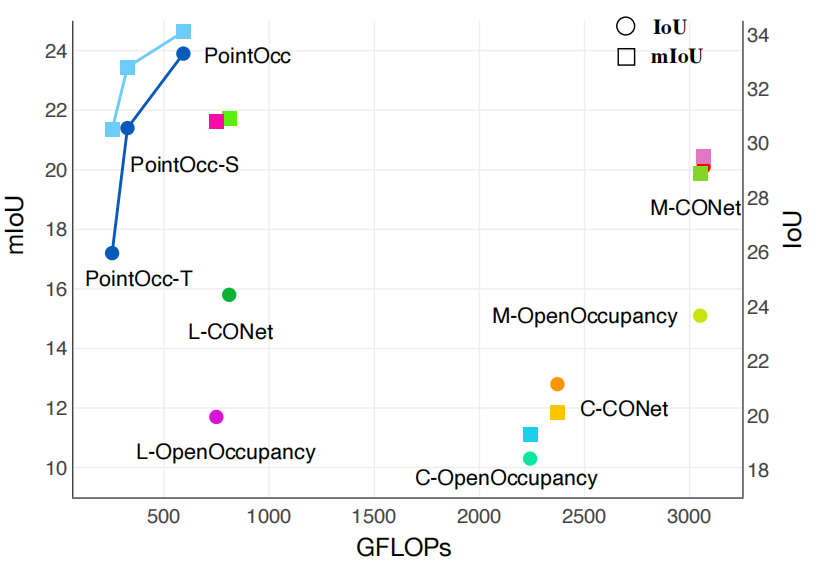
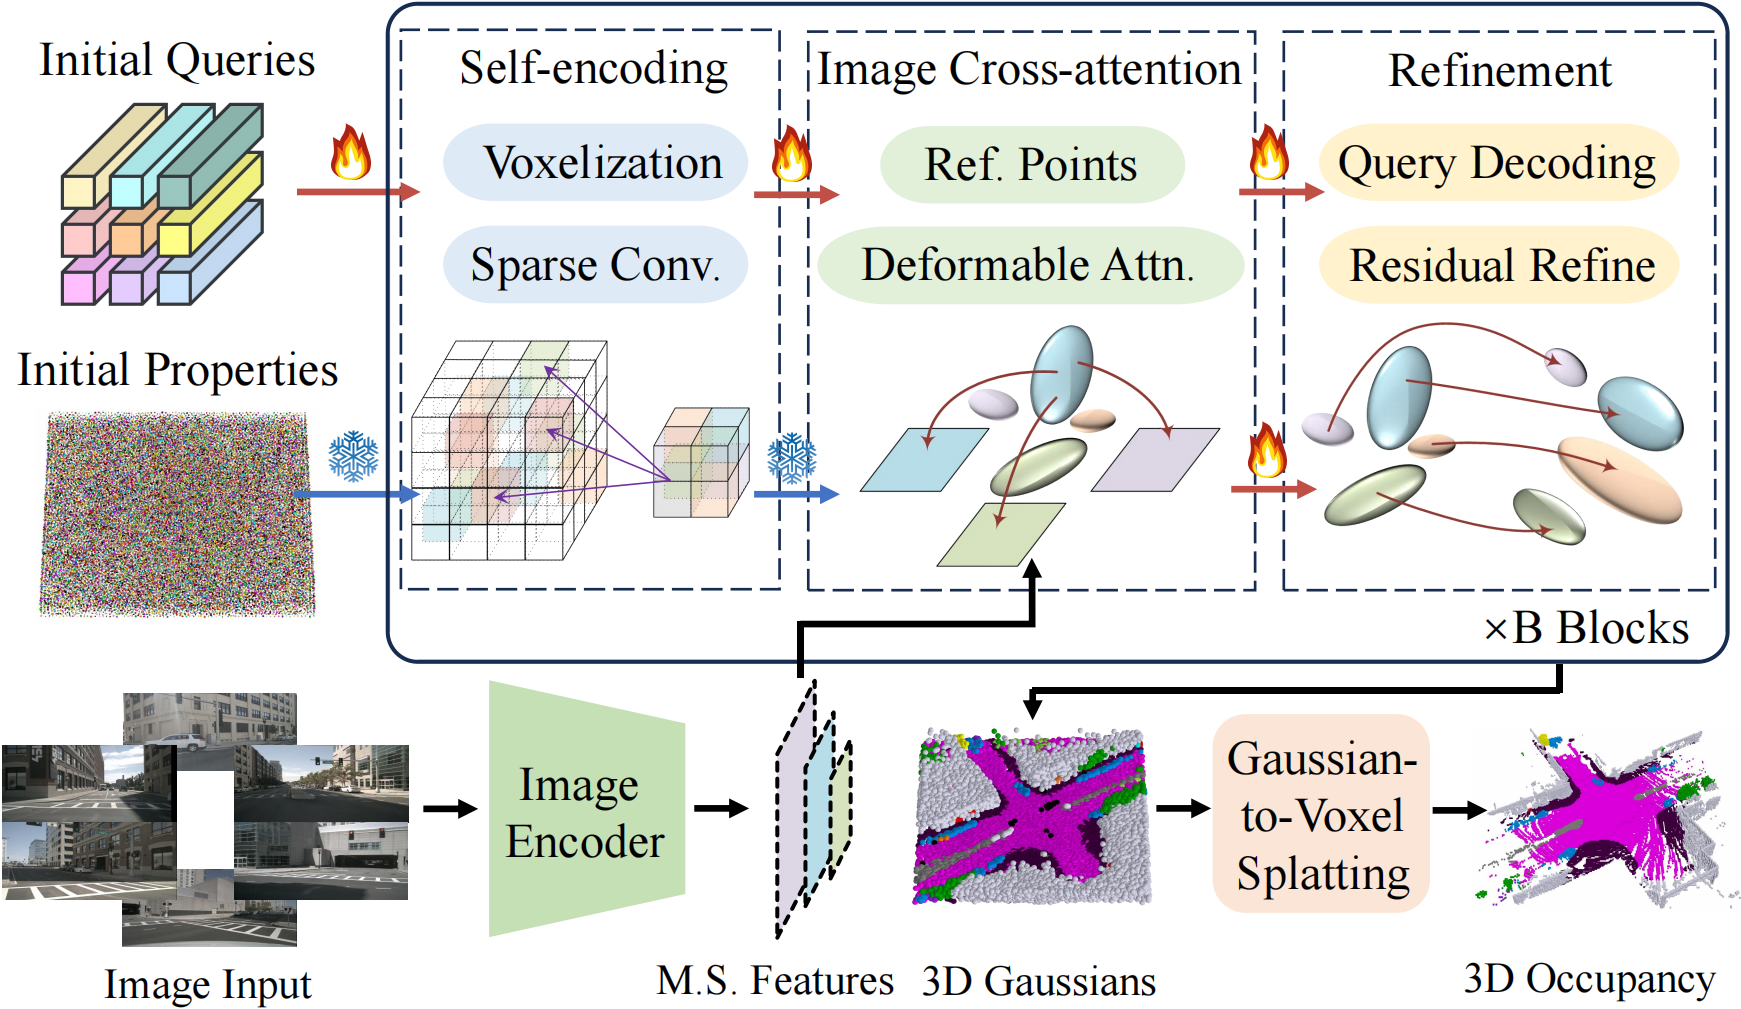
以稀疏高斯表示场景,并拓展至时序建模。
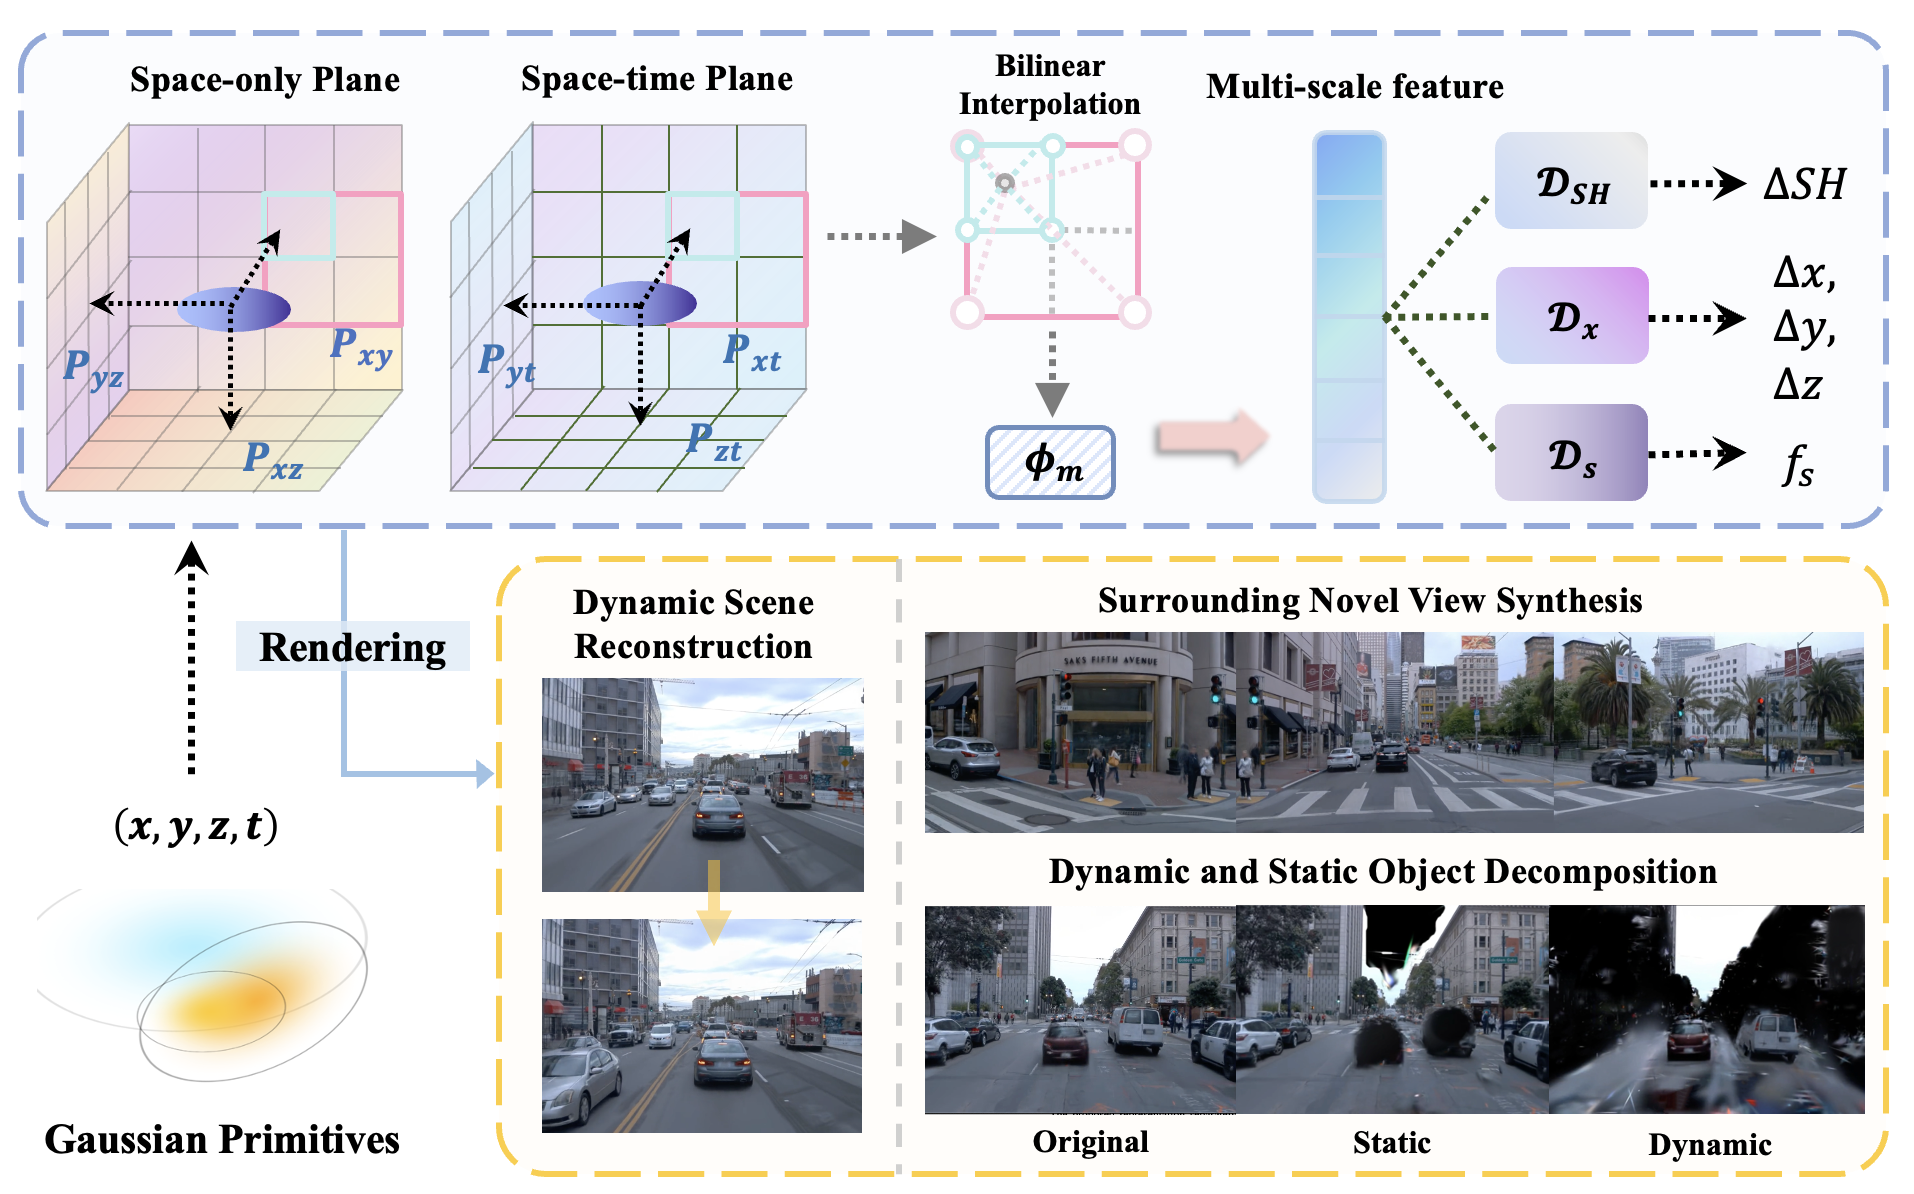
利用三维高斯与时空场重建驾驶场景,通过四维一致性分离静态和动态内容,无需带跟踪信息的三维车辆框。
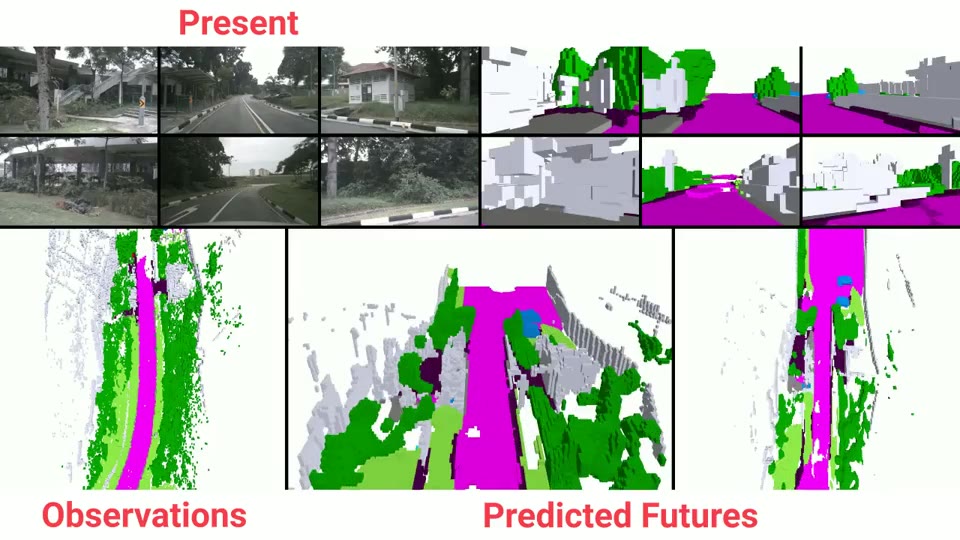
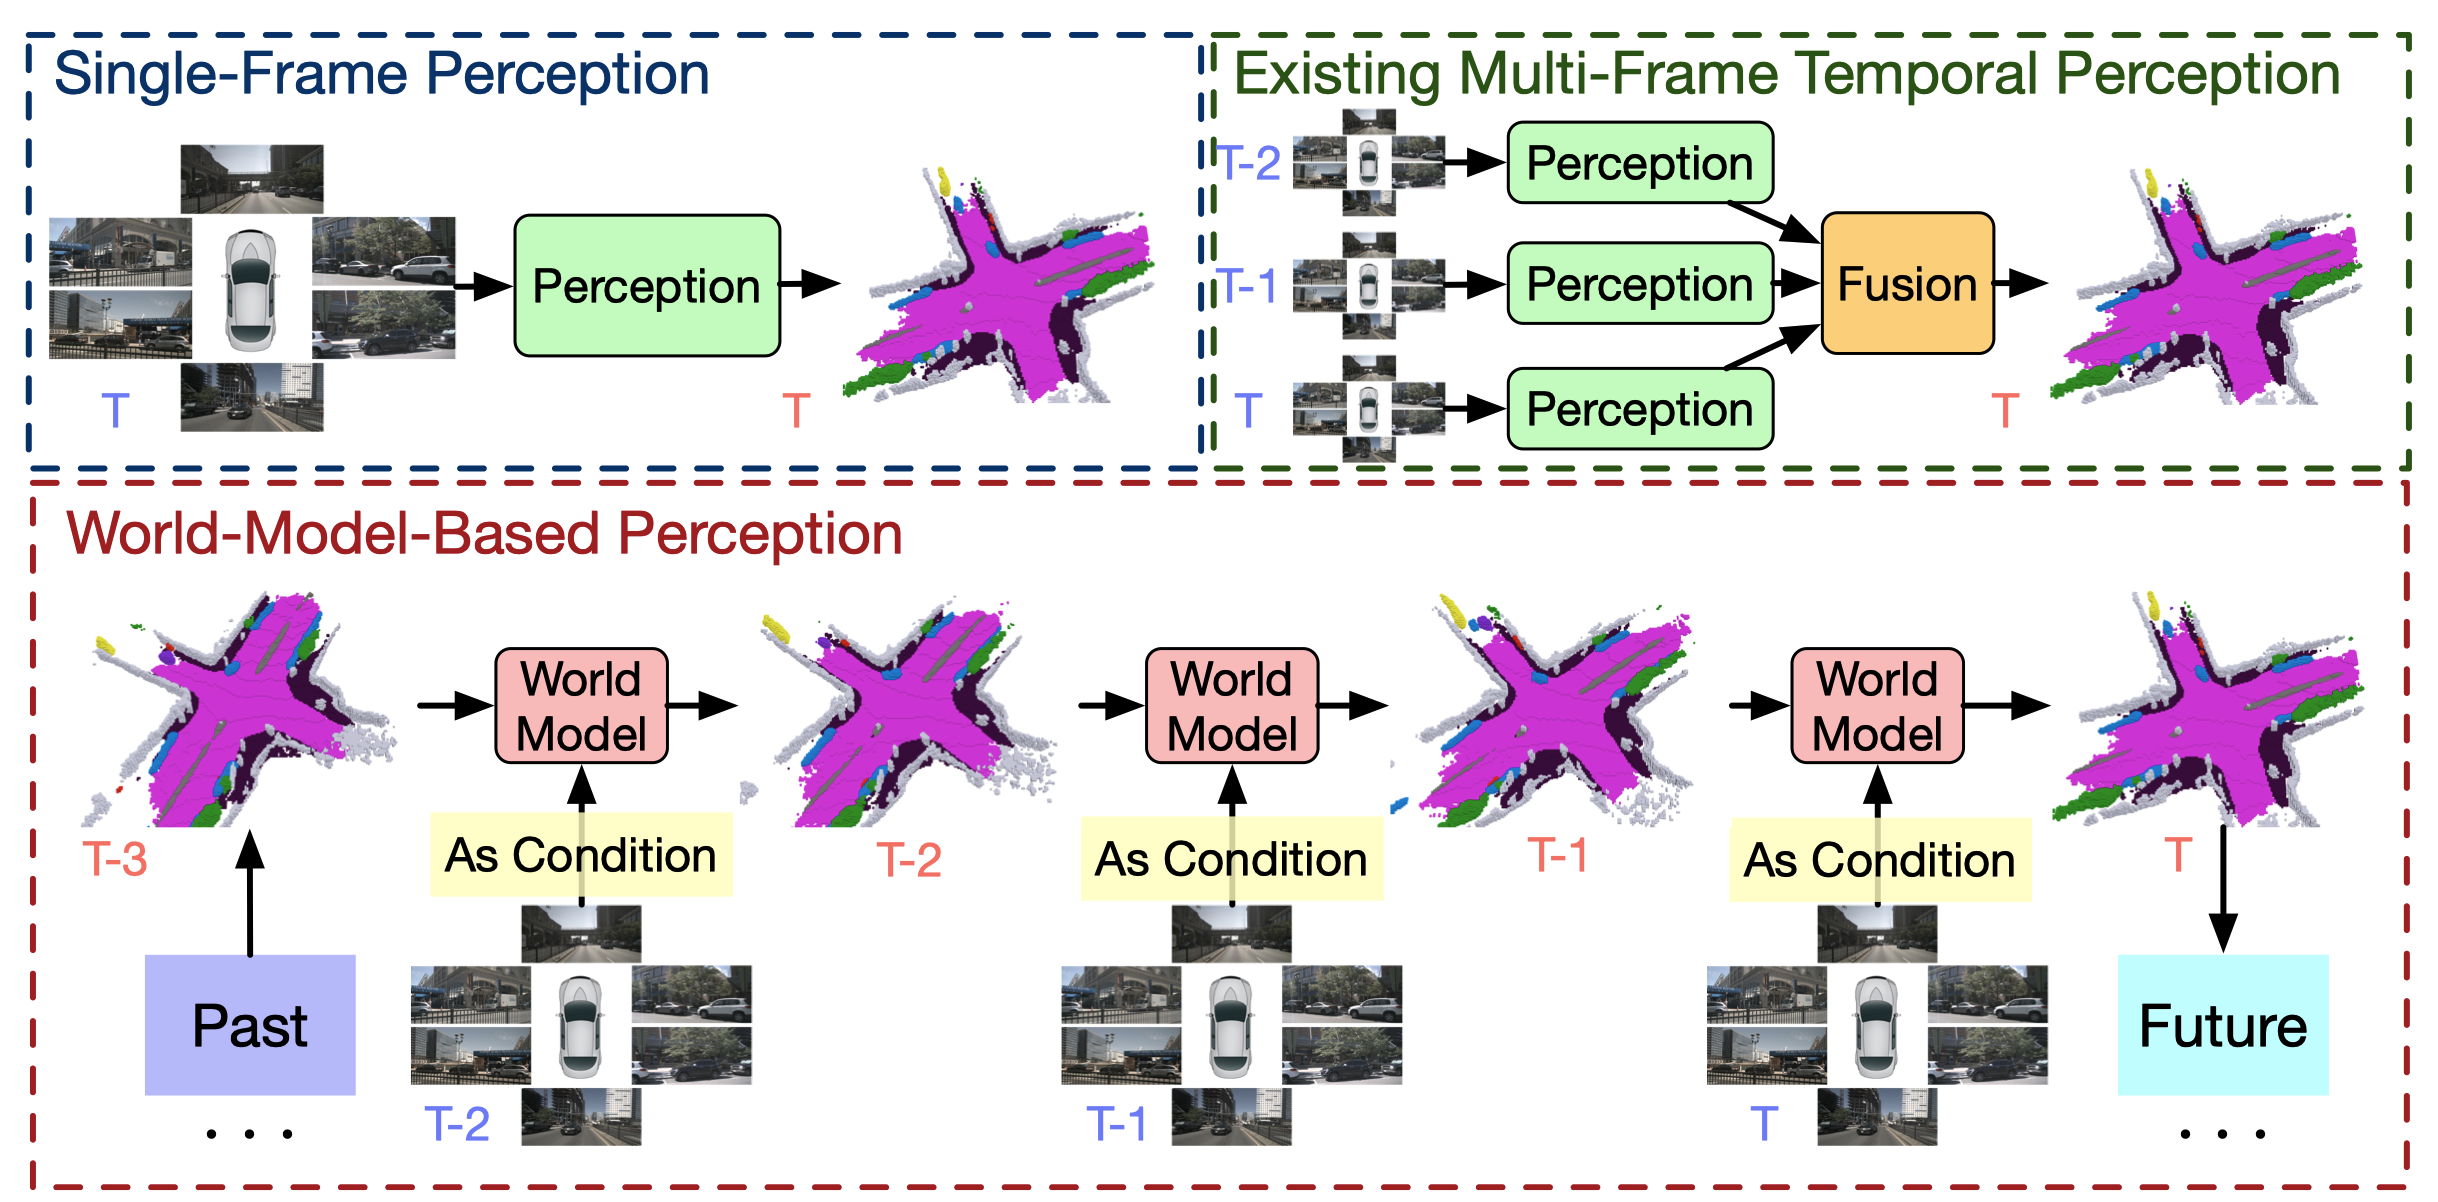
结合自车运动、物体运动与新区域补全,持续更新高斯场景。预测以当前图像为条件,服务于连续占用感知。
持续融合新观测,无需每次从头重建整个场景。
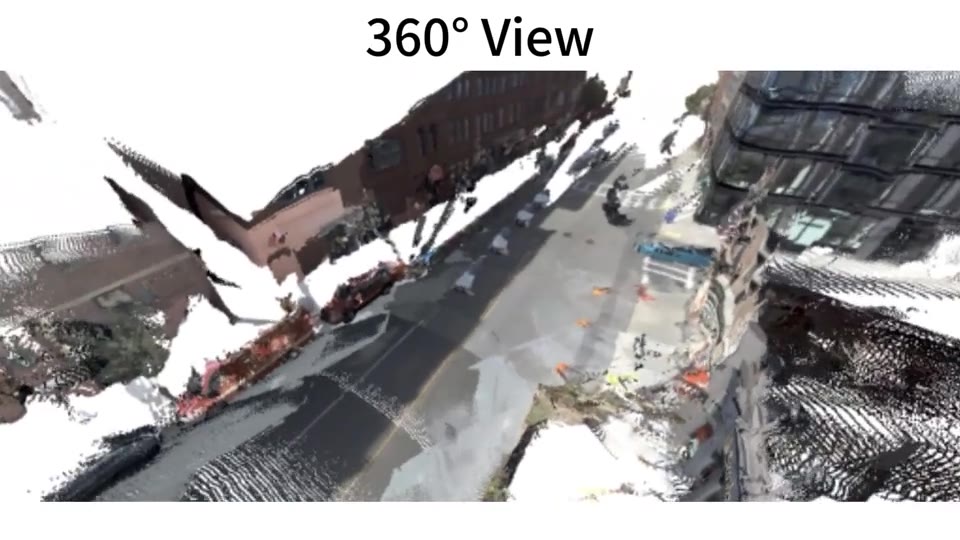
维护与三维位置绑定的显式空间指针,聚合邻近观测,为流式重建建立与场景结构对应的记忆。
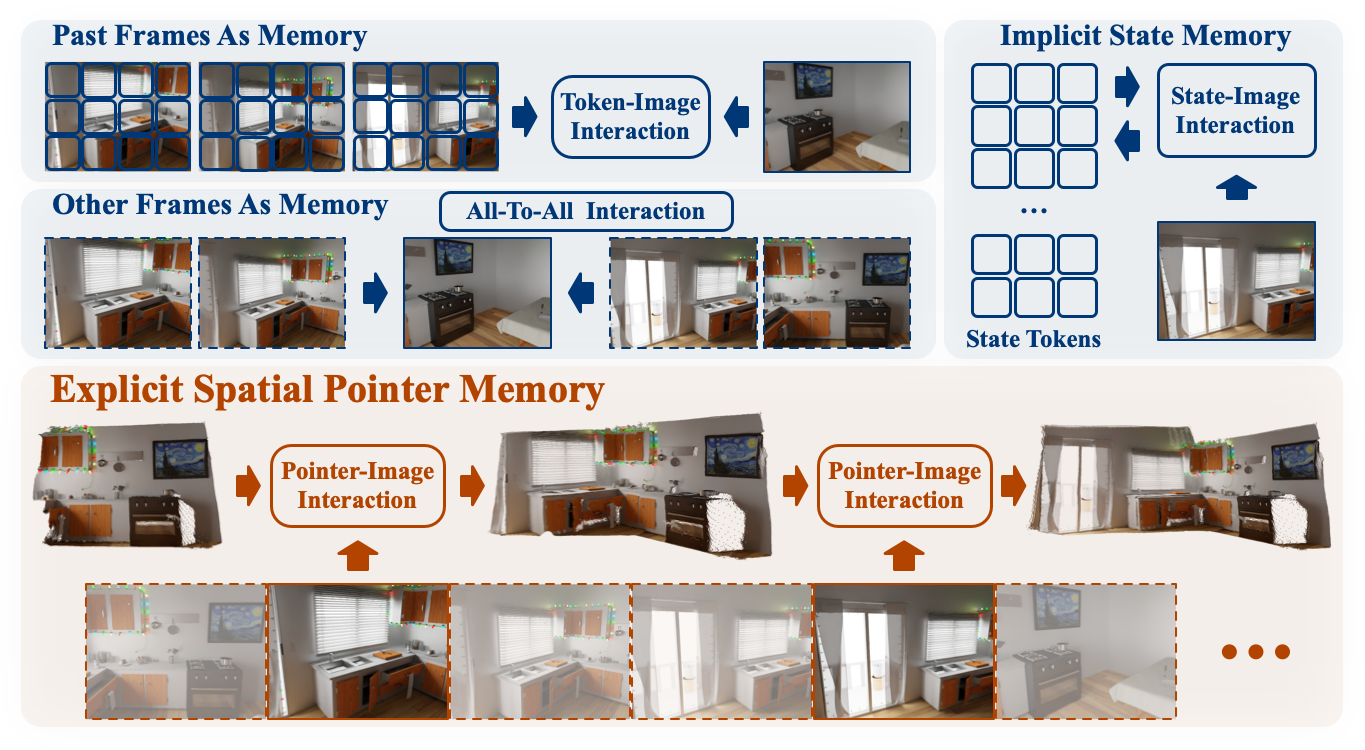
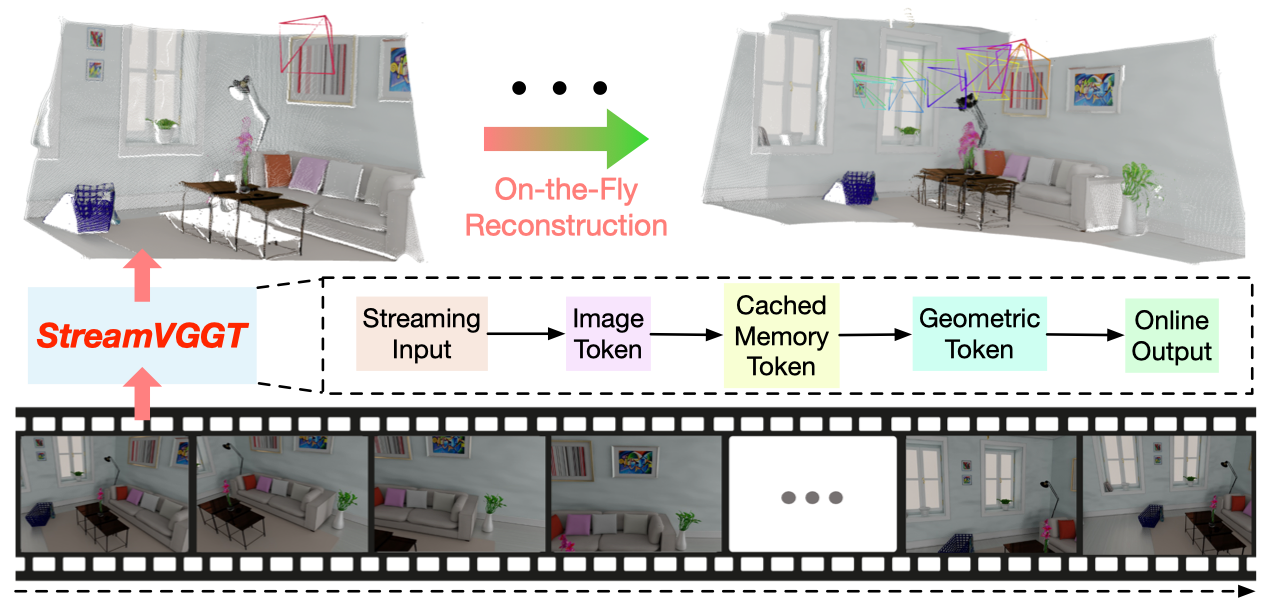
通过因果注意力与缓存记忆,将离线视觉几何估计推进为增量式、低延迟的在线重建。
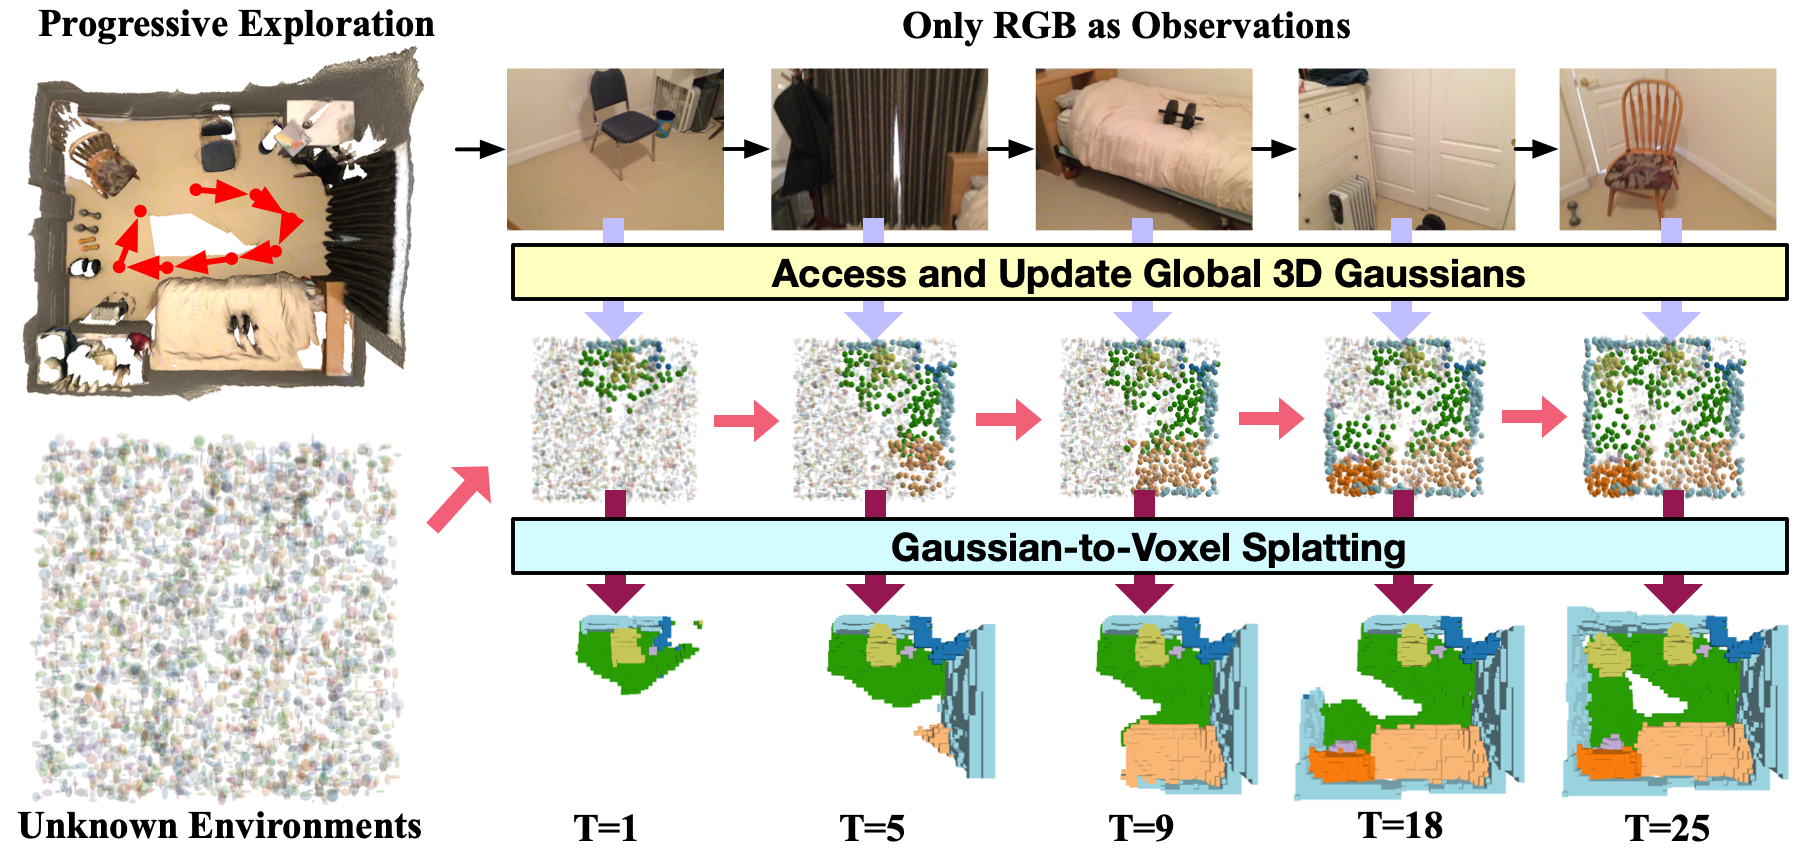
EmbodiedOcc 维护全局高斯场景记忆,随着智能体探索逐步更新已观测区域,将占用预测从孤立视角扩展到在线具身场景理解。
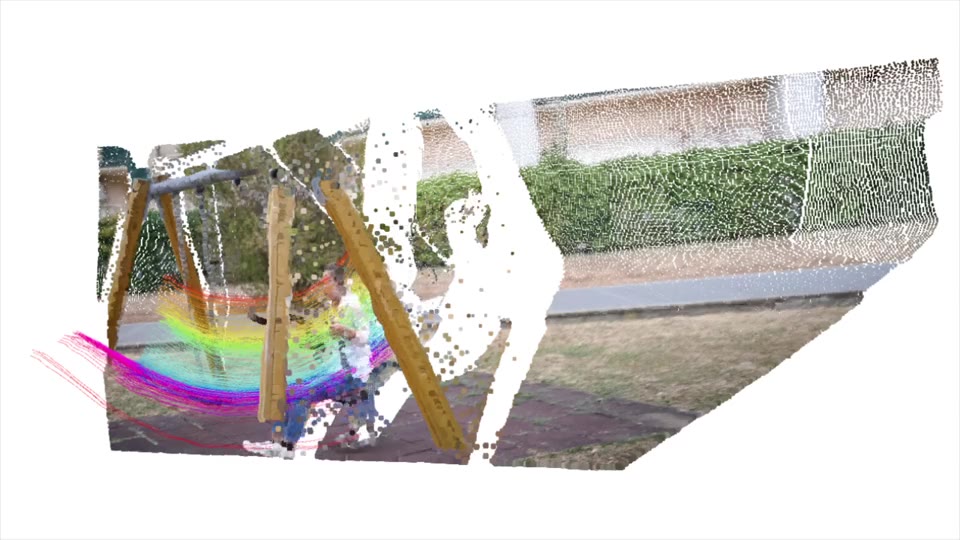
将连续表面与结构化运动连接起来,形成更完备的场景表示。
学习可在任意位置查询的隐式场景场,在统一表征中连接连贯的表面重建与新视角渲染。
用共享运动基表示动态场景,超越彼此独立的逐点位移预测,推进结构化四维重建。
More coming soon
探索面向仿真的生成式几何基础模型。
我们研究如何表示和生成变化中的世界:OccWorld 建模三维场景动态,SVG 探索面向生成的语义表示,Astra 预测不同动作条件下的视觉序列。现在我们关注:
视频加载失败,可通过下方项目链接查看原始演示。
视频加载失败,可通过下方项目链接查看原始演示。
视频加载失败,可通过下方项目链接查看原始演示。
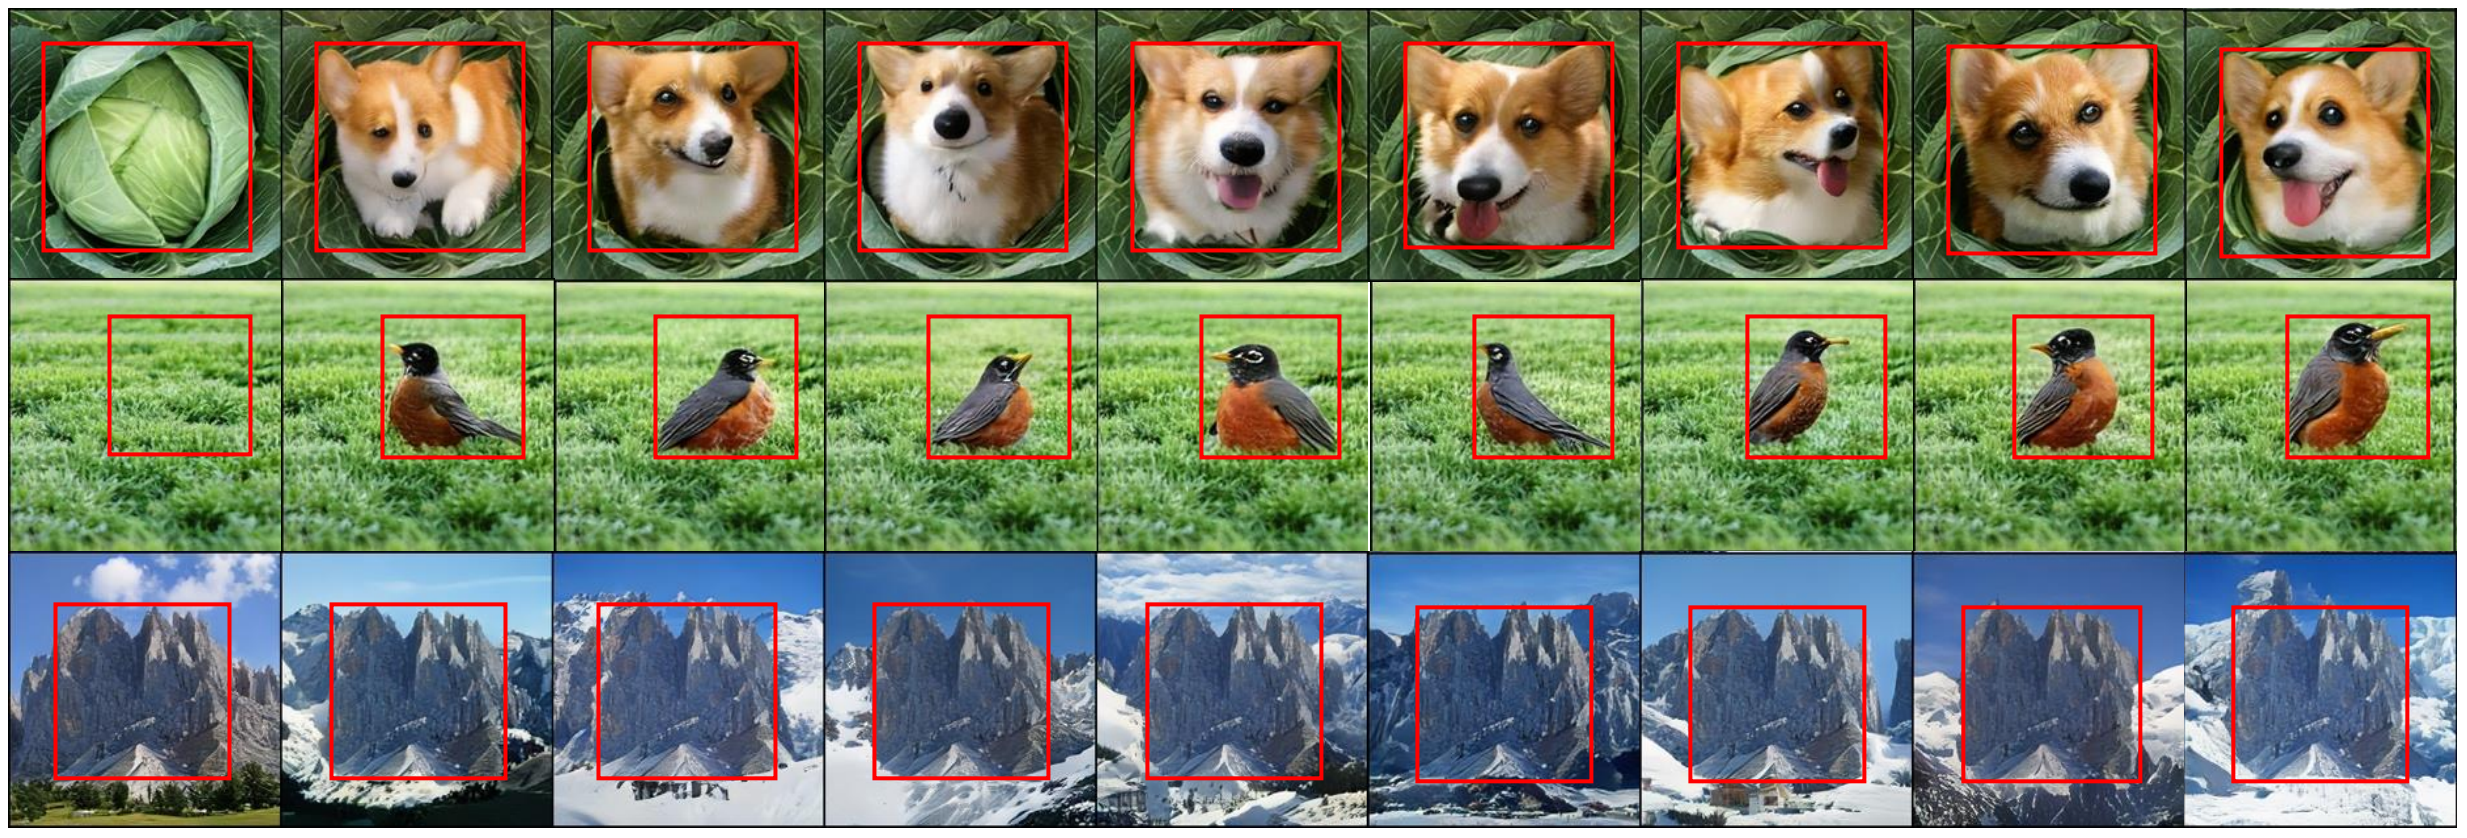
我们的工作涵盖显式三维动态、持续隐状态、语义生成表征与动作条件视频。可通过相机探索的场景,不等同于能够响应具身动作的世界。我们希望连接生成与理解,并建立让智能体通过交互检验预测的支撑系统。
待研究的问题 世界模型需要表示哪些信息,才能预测接触、操作以及具身智能体造成的持续变化?
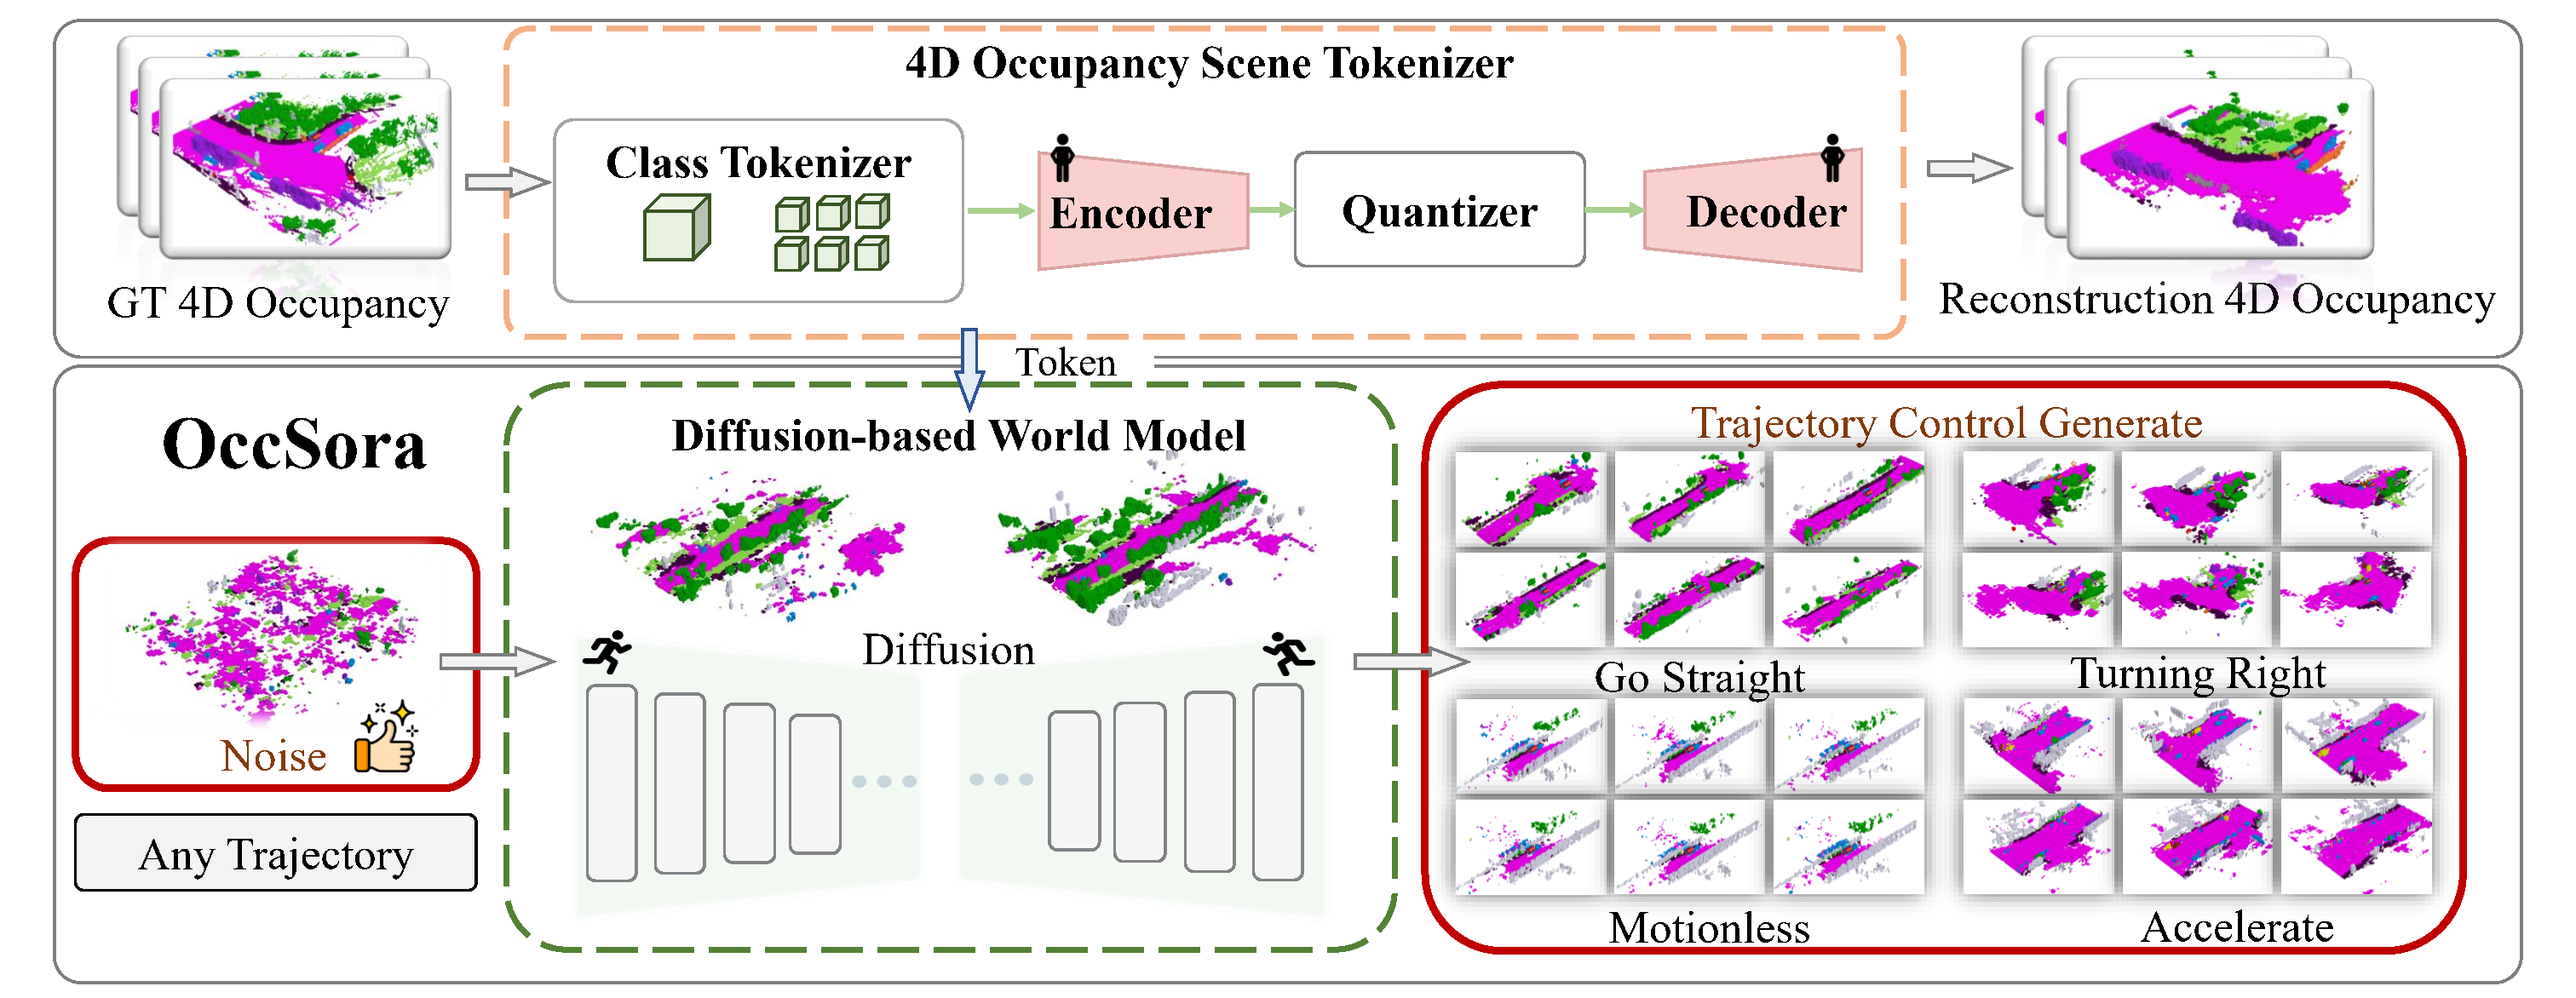
通过显式三维状态与持续隐状态动态,预测场景演化。
将四维占用分词器与扩散模型结合,根据指定轨迹生成具有时间一致性的场景序列。
Owl-1 将持续隐状态、视觉观测与动态演化分离建模,支持一致的长视频生成。其潜在世界状态不同于显式三维占用表示。
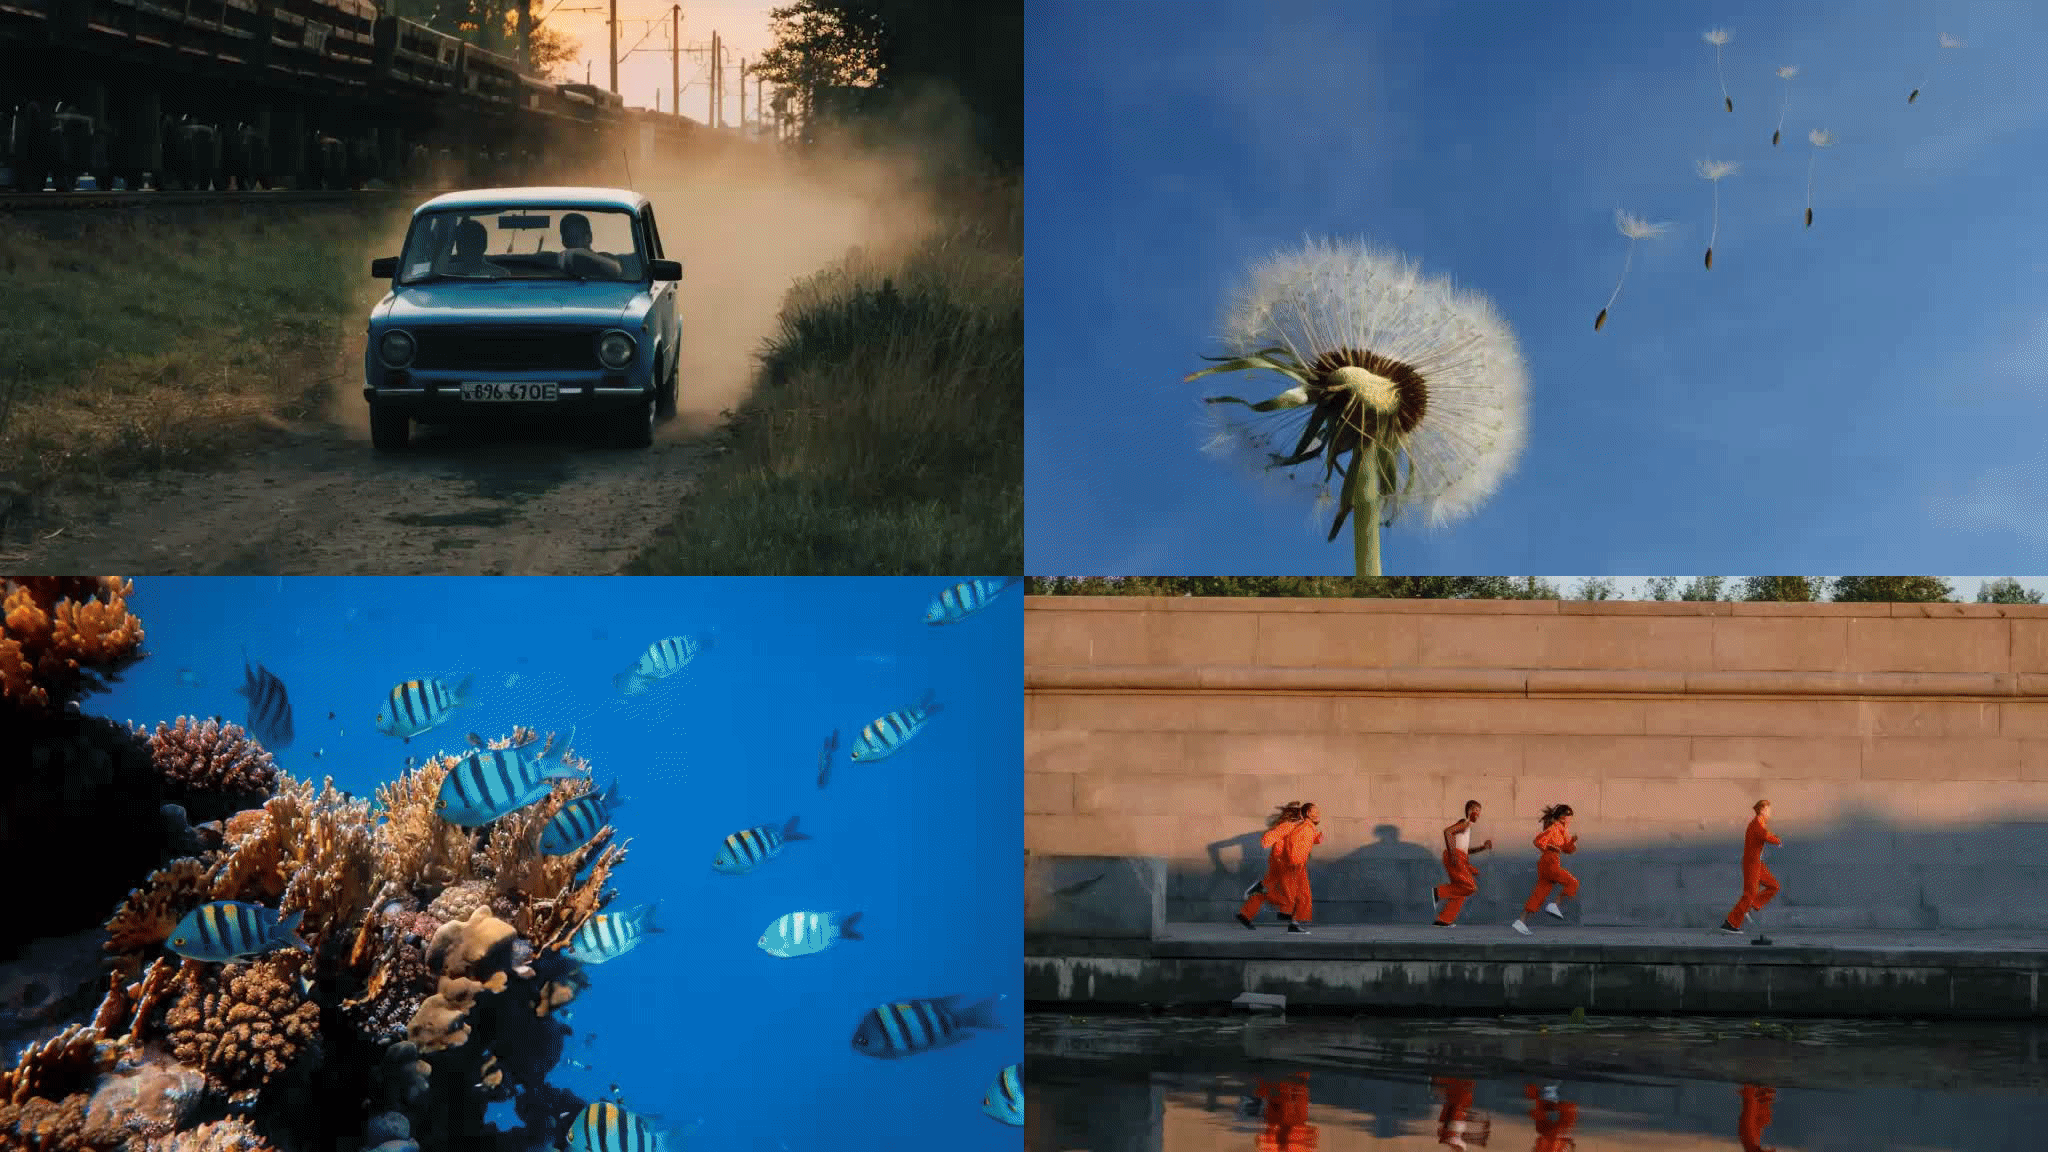
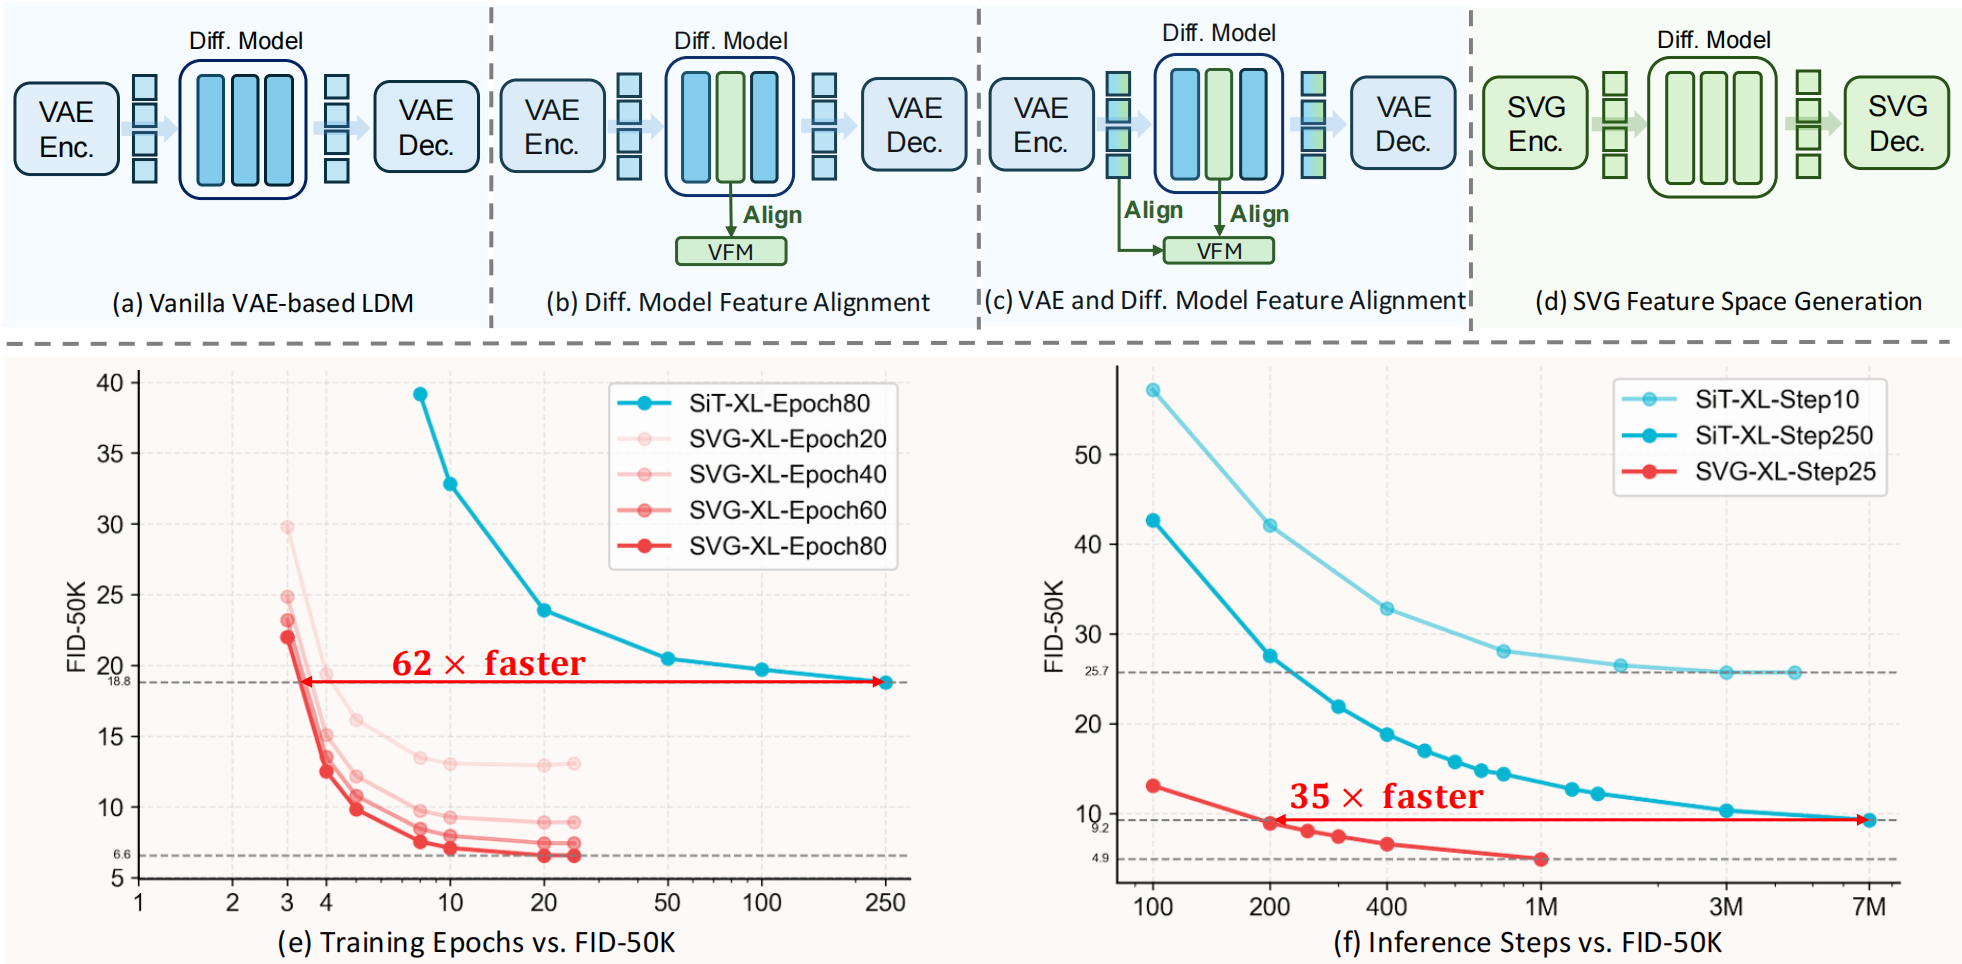
连接生成表征、可探索的四维场景与动作条件下的未来预测。
将冻结的视觉特征与残差细节分支结合,实现不依赖 VAE 的潜空间扩散。SVG 探索生成基础模型;动作条件下的动态建模是另一层研究问题。
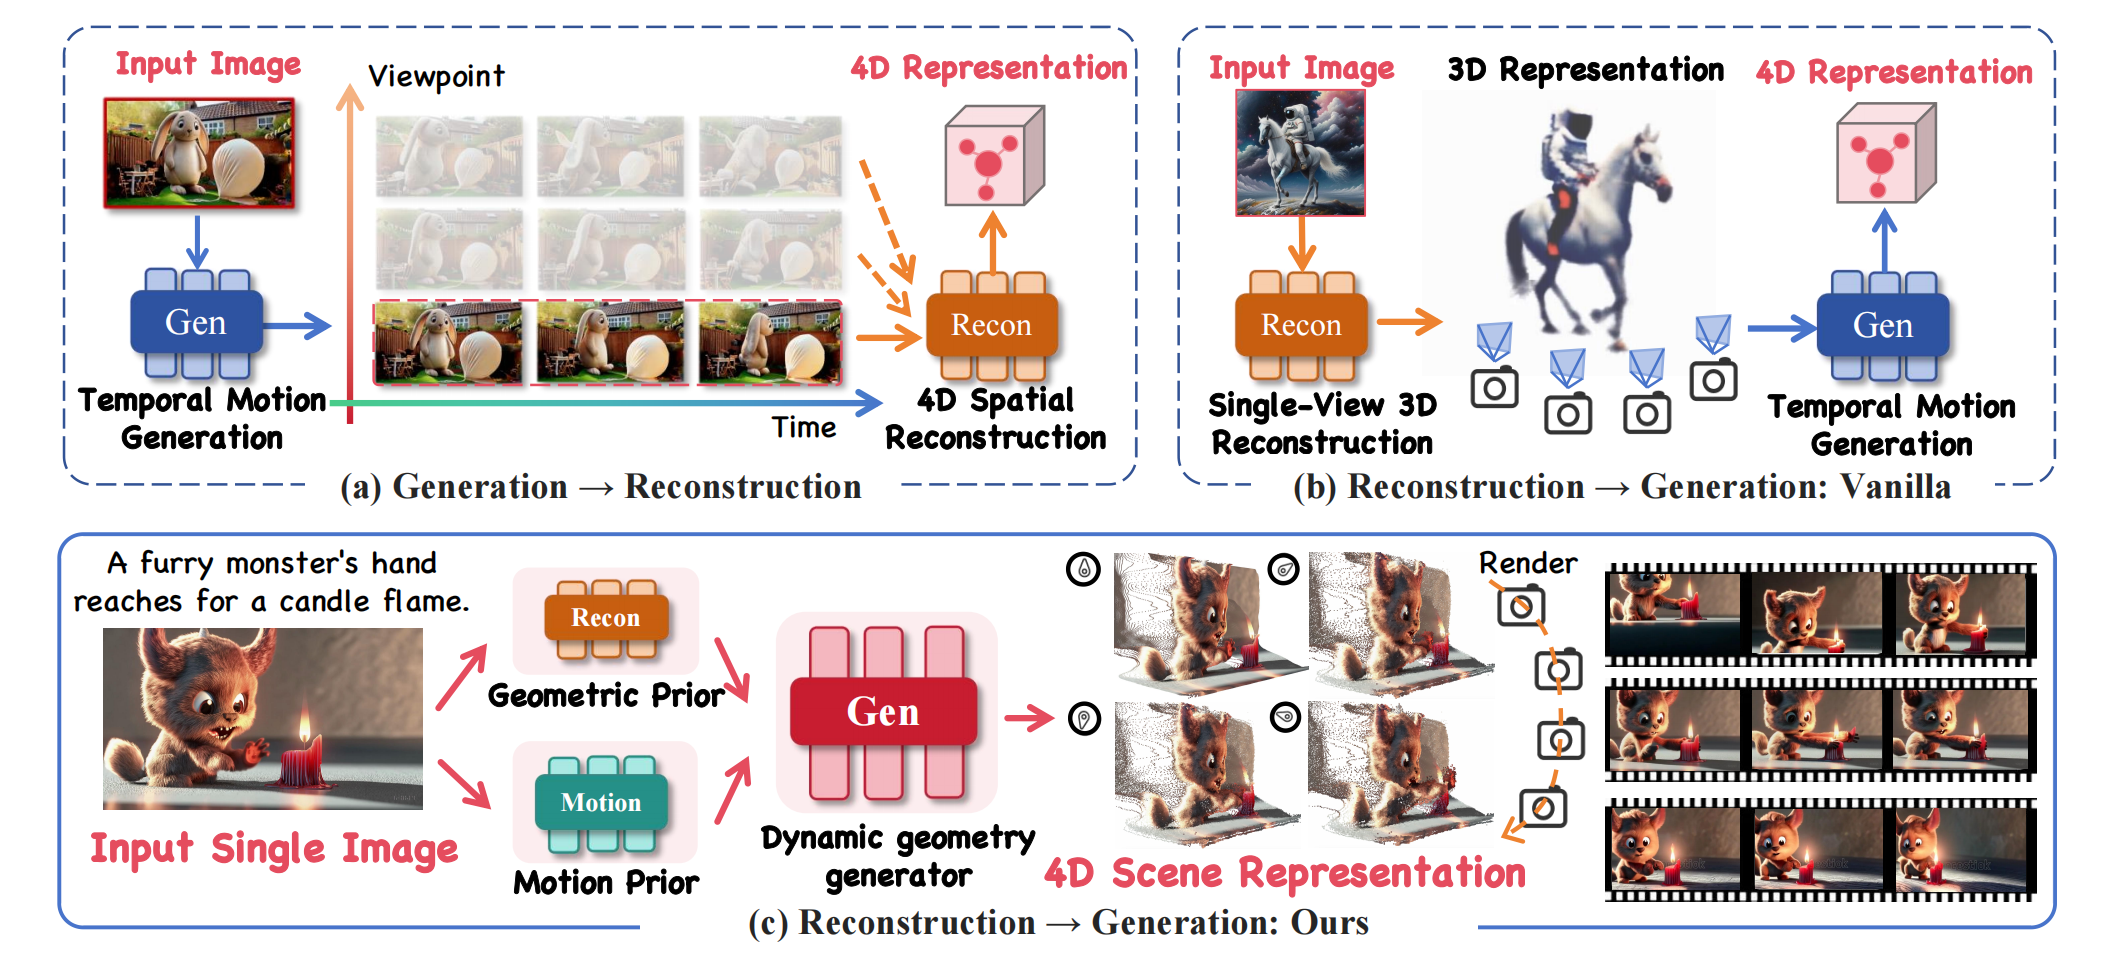
MoRe4D 现更名为 MoGe4D,从单张图像生成稠密四维轨迹并渲染新视角,探索几何一致的动态生成,尚不等同于机器人参与的物理交互。
从探索生成的场景,走向通过具身交互改变场景。
More coming soon
让具身本体通过执行操作参与世界互动,建模动作如何改变世界,并利用反馈指导下一次交互。
过去我们主要研究自动驾驶系统,推动了生成式端到端自动驾驶、世界动作模型与多模态闭环驾驶基础模型的发展,并提出视觉几何动作模型的新范式。现在,我们开始关注更通用的机器人:
视频加载失败,可通过下方项目链接查看原始演示。
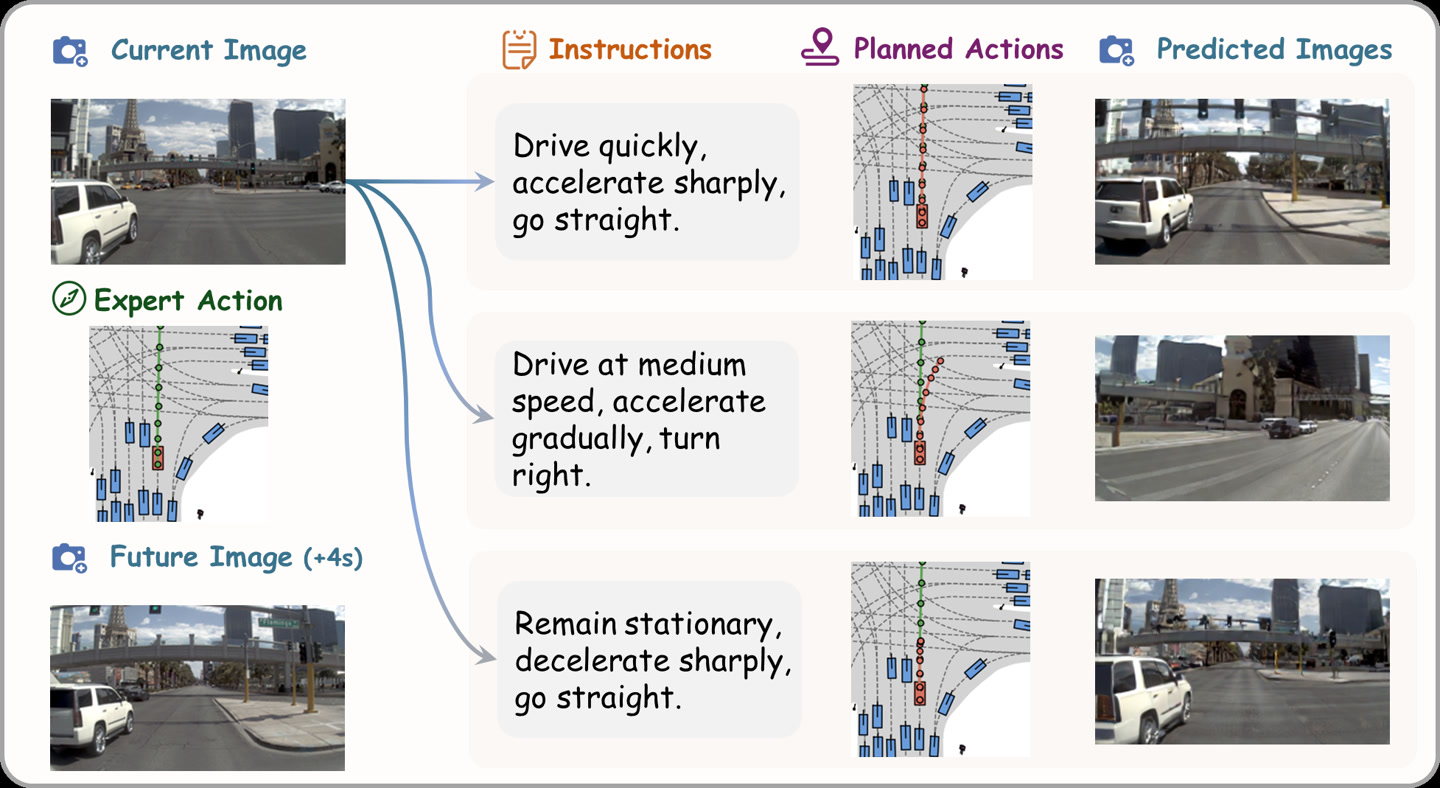
我们的自动驾驶研究连接了生成、空间理解、语言与行动。这些成果启发了面向人形机器人的进一步探索,但驾驶表现本身并不能证明通用全身控制或触觉灵巧操作能力。
待研究的问题 如何让人形机器人协调移动与灵巧操作,并结合触觉和视觉反馈调整动作?
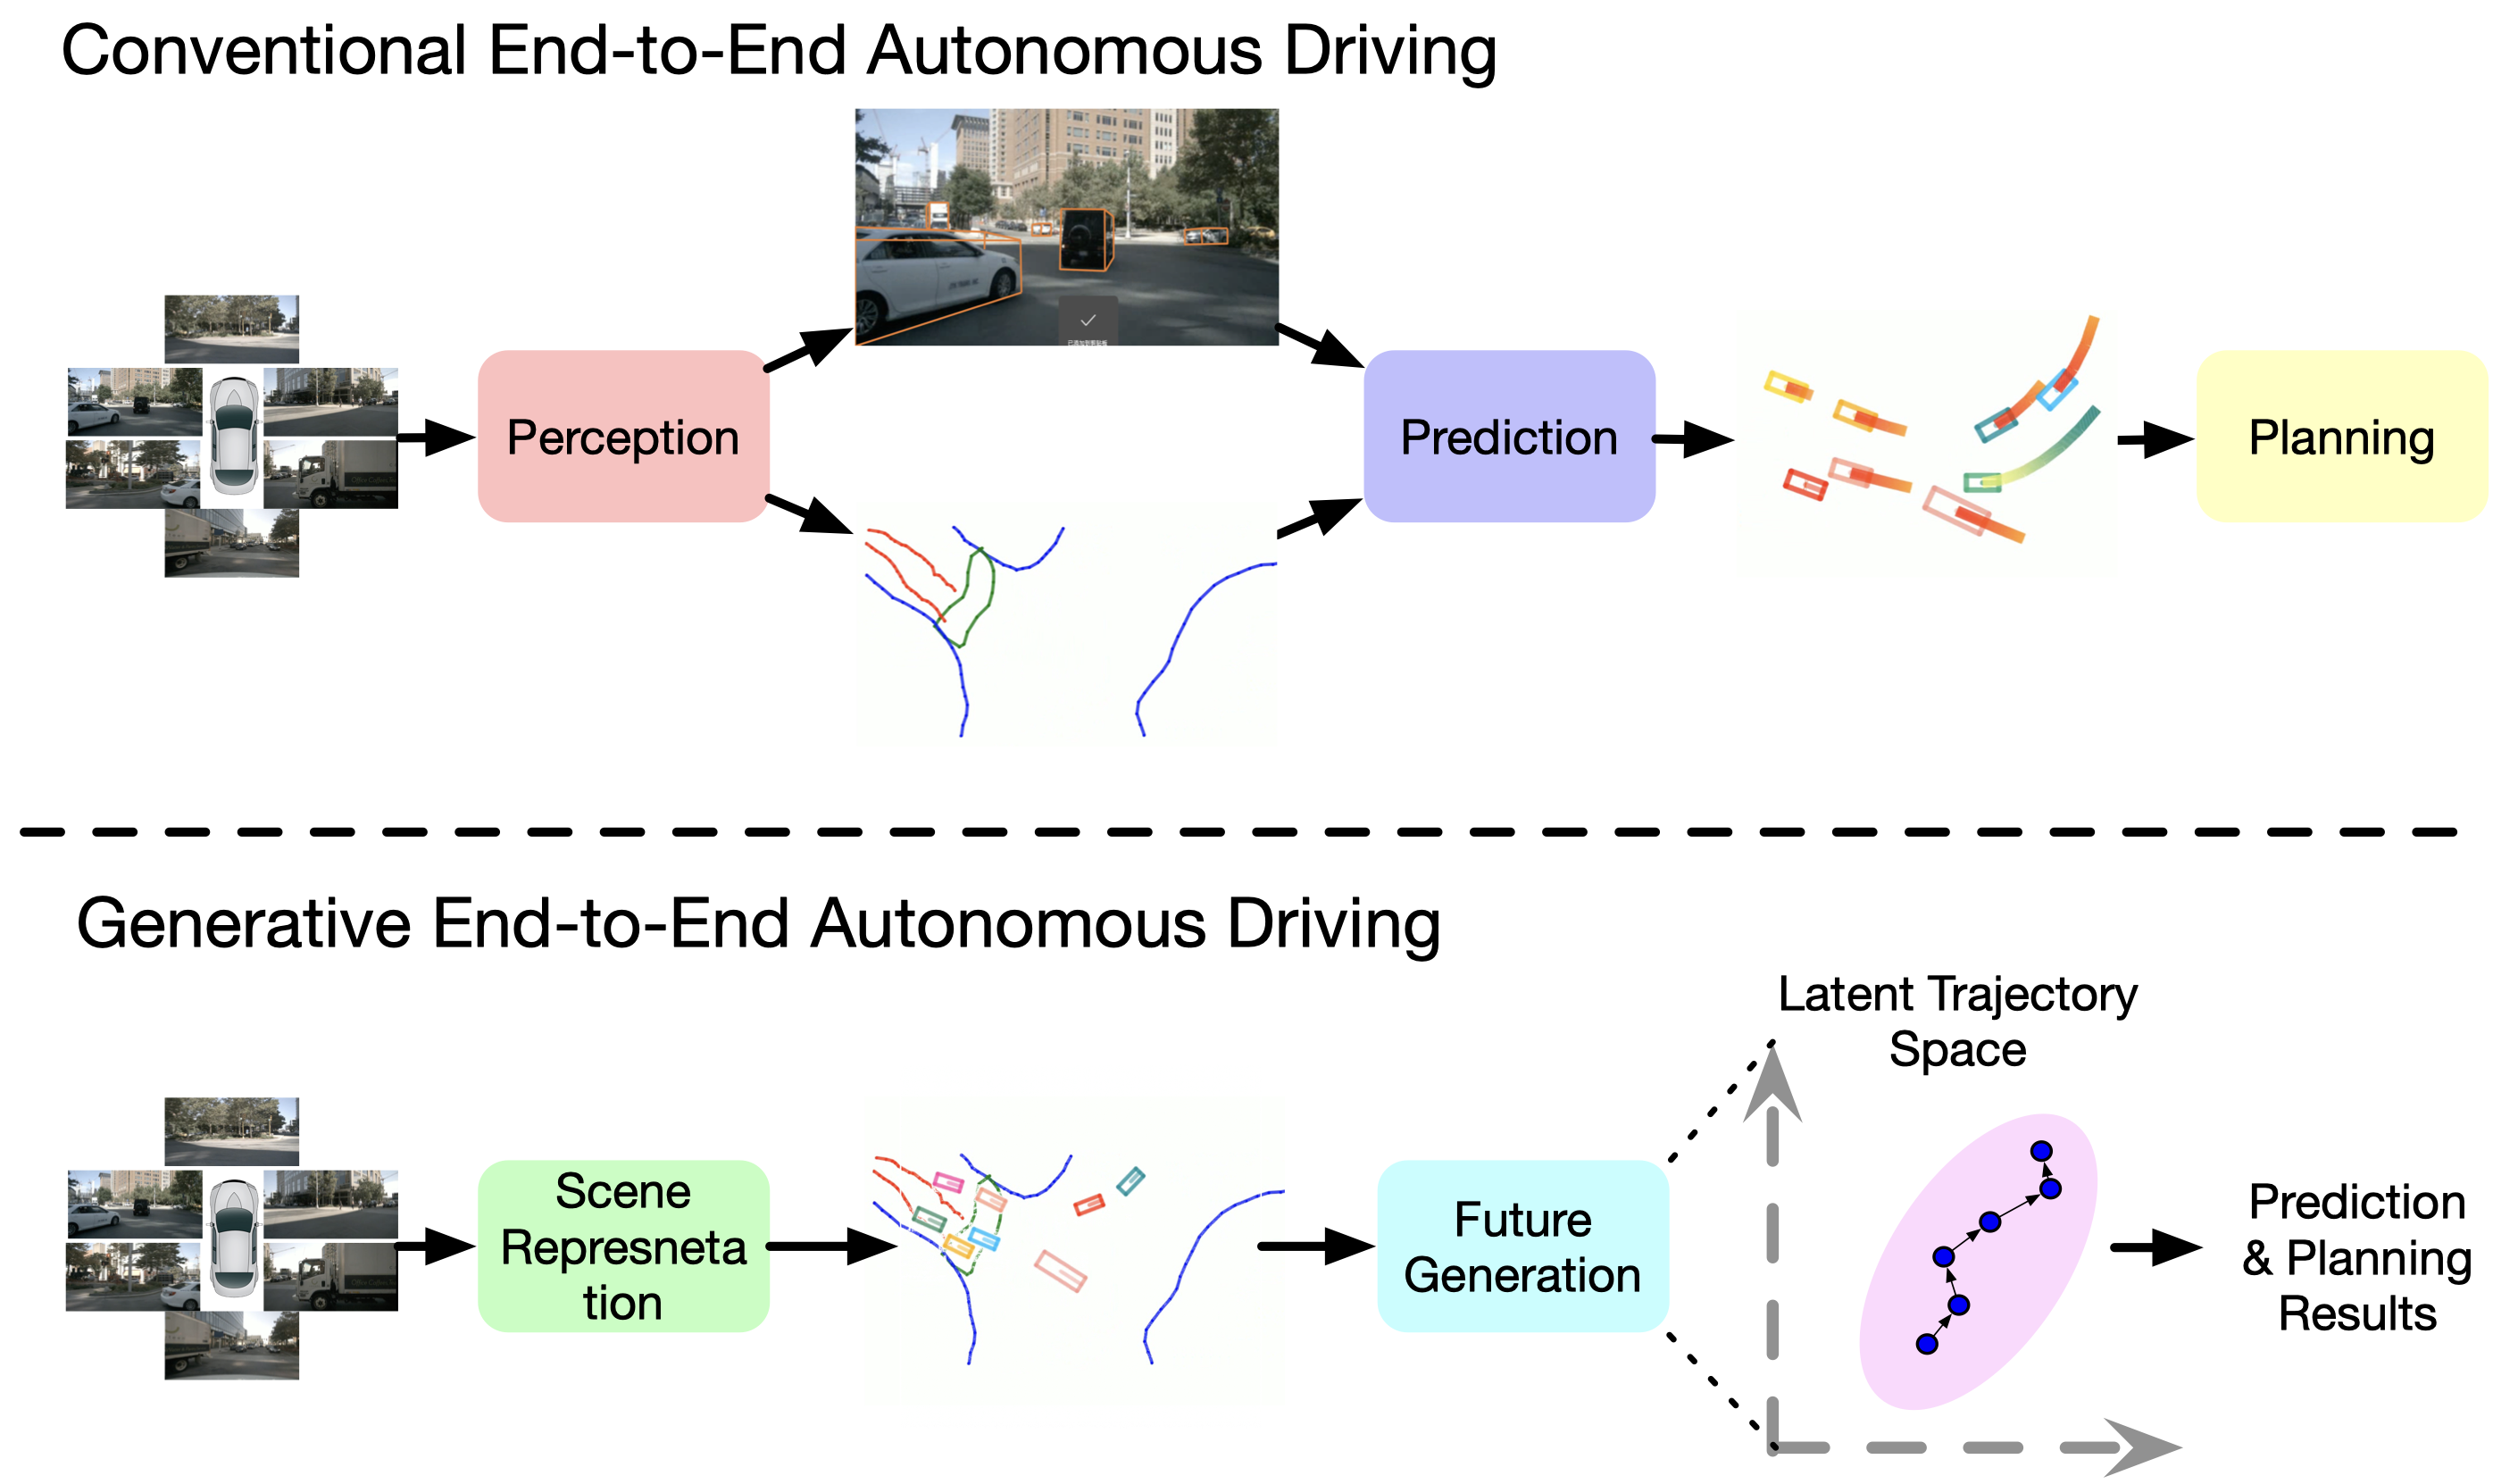
在统一的驾驶模型中连接感知、未来生成与规划。
将驾驶转化为未来生成问题,在结构化潜在空间中联合建模其他交通参与者的运动与自车轨迹。
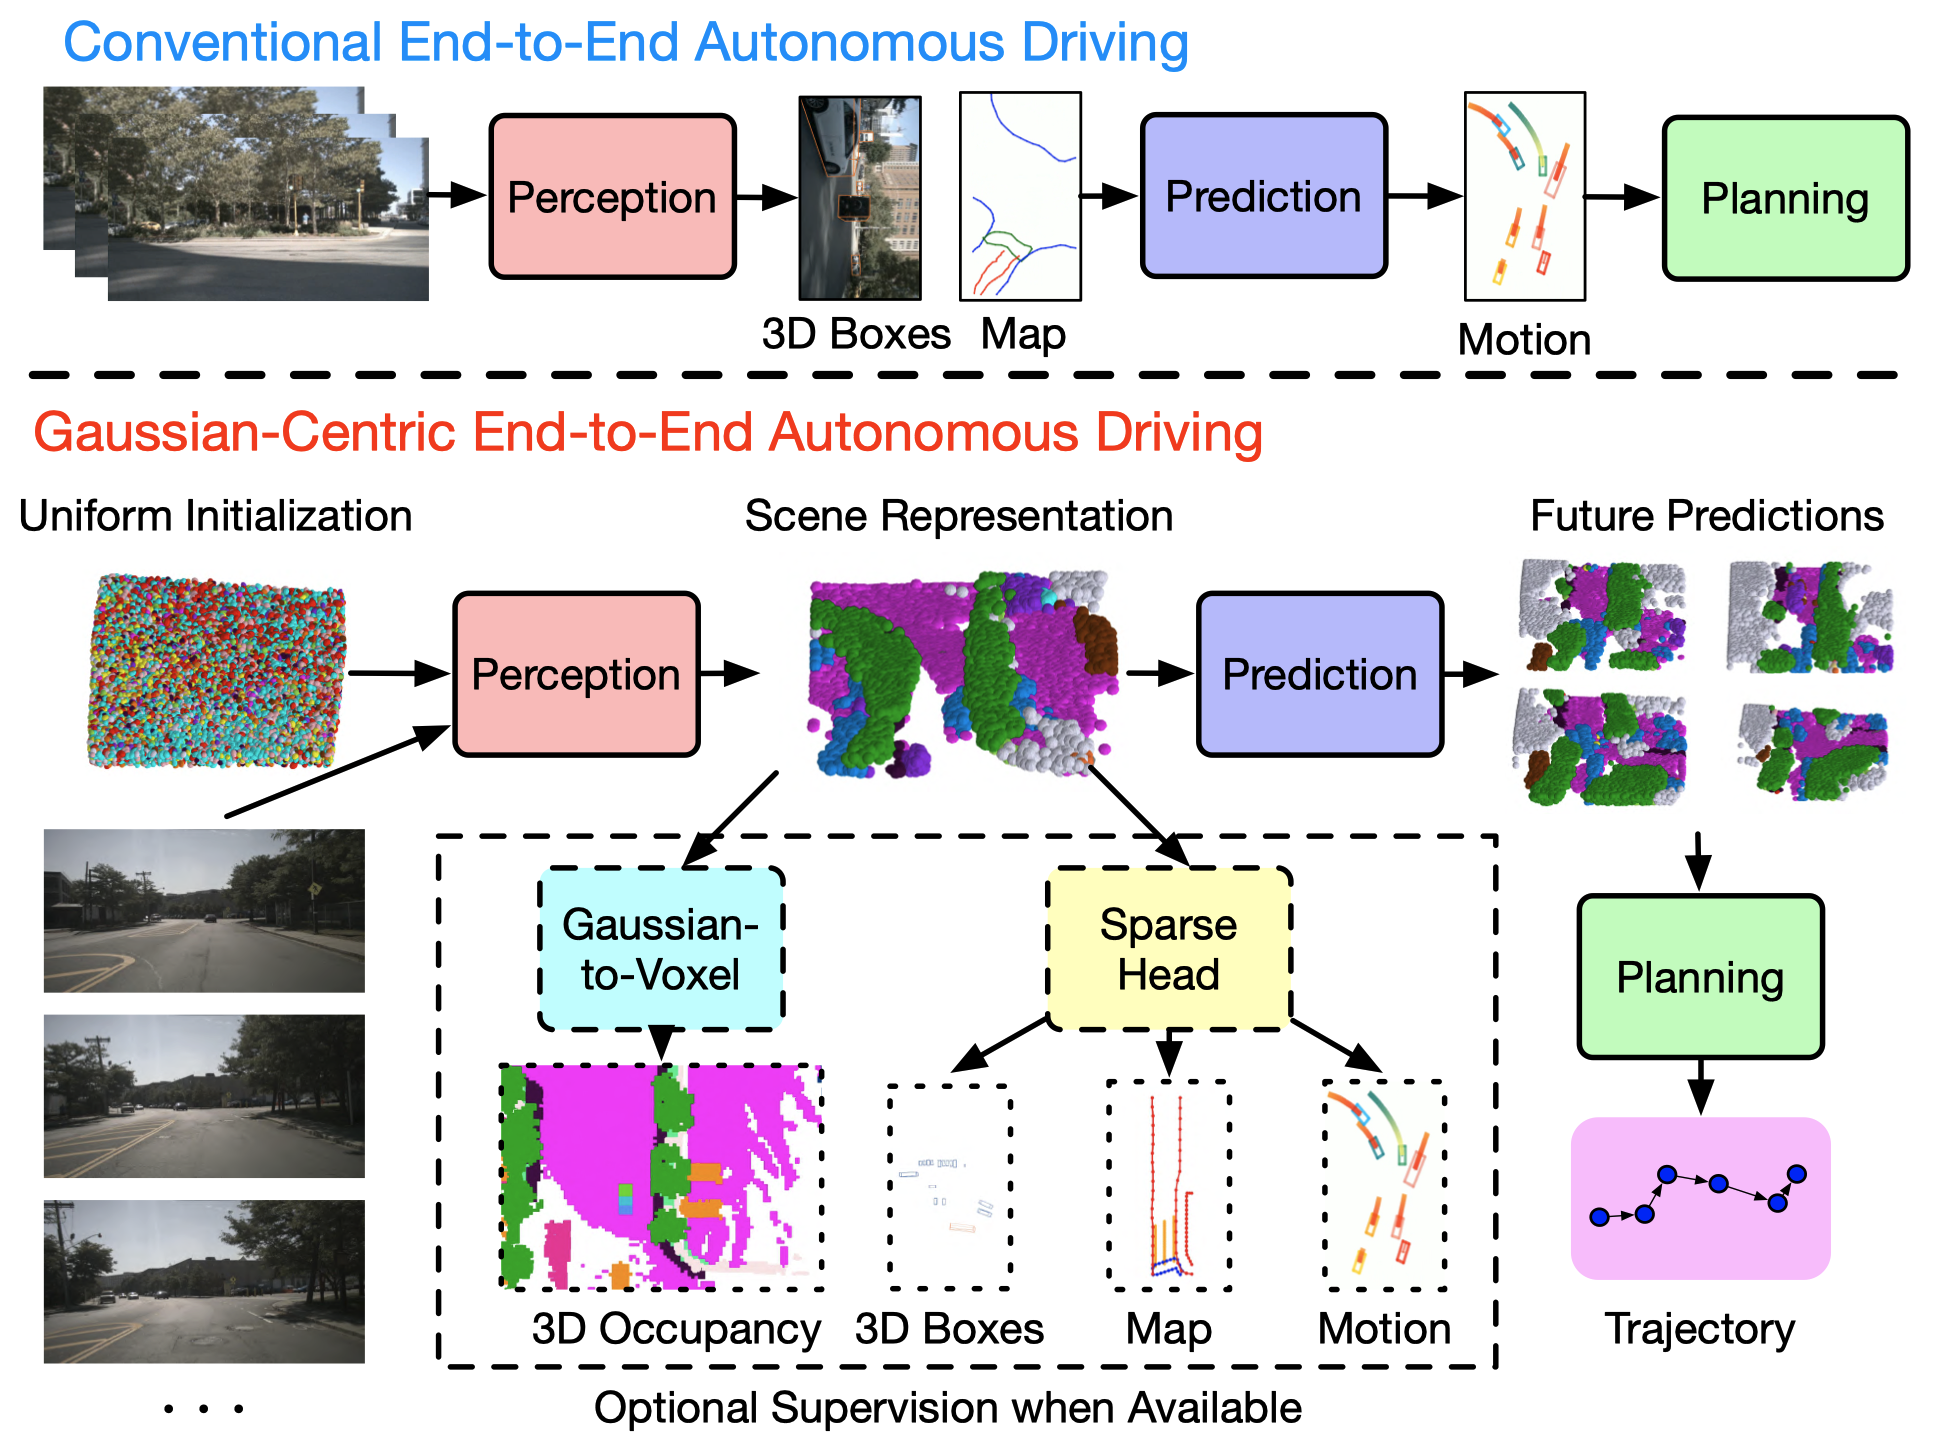
在端到端驾驶模型中连接语义高斯、未来场景预测与自车轨迹,让稀疏空间表示贯穿决策过程。
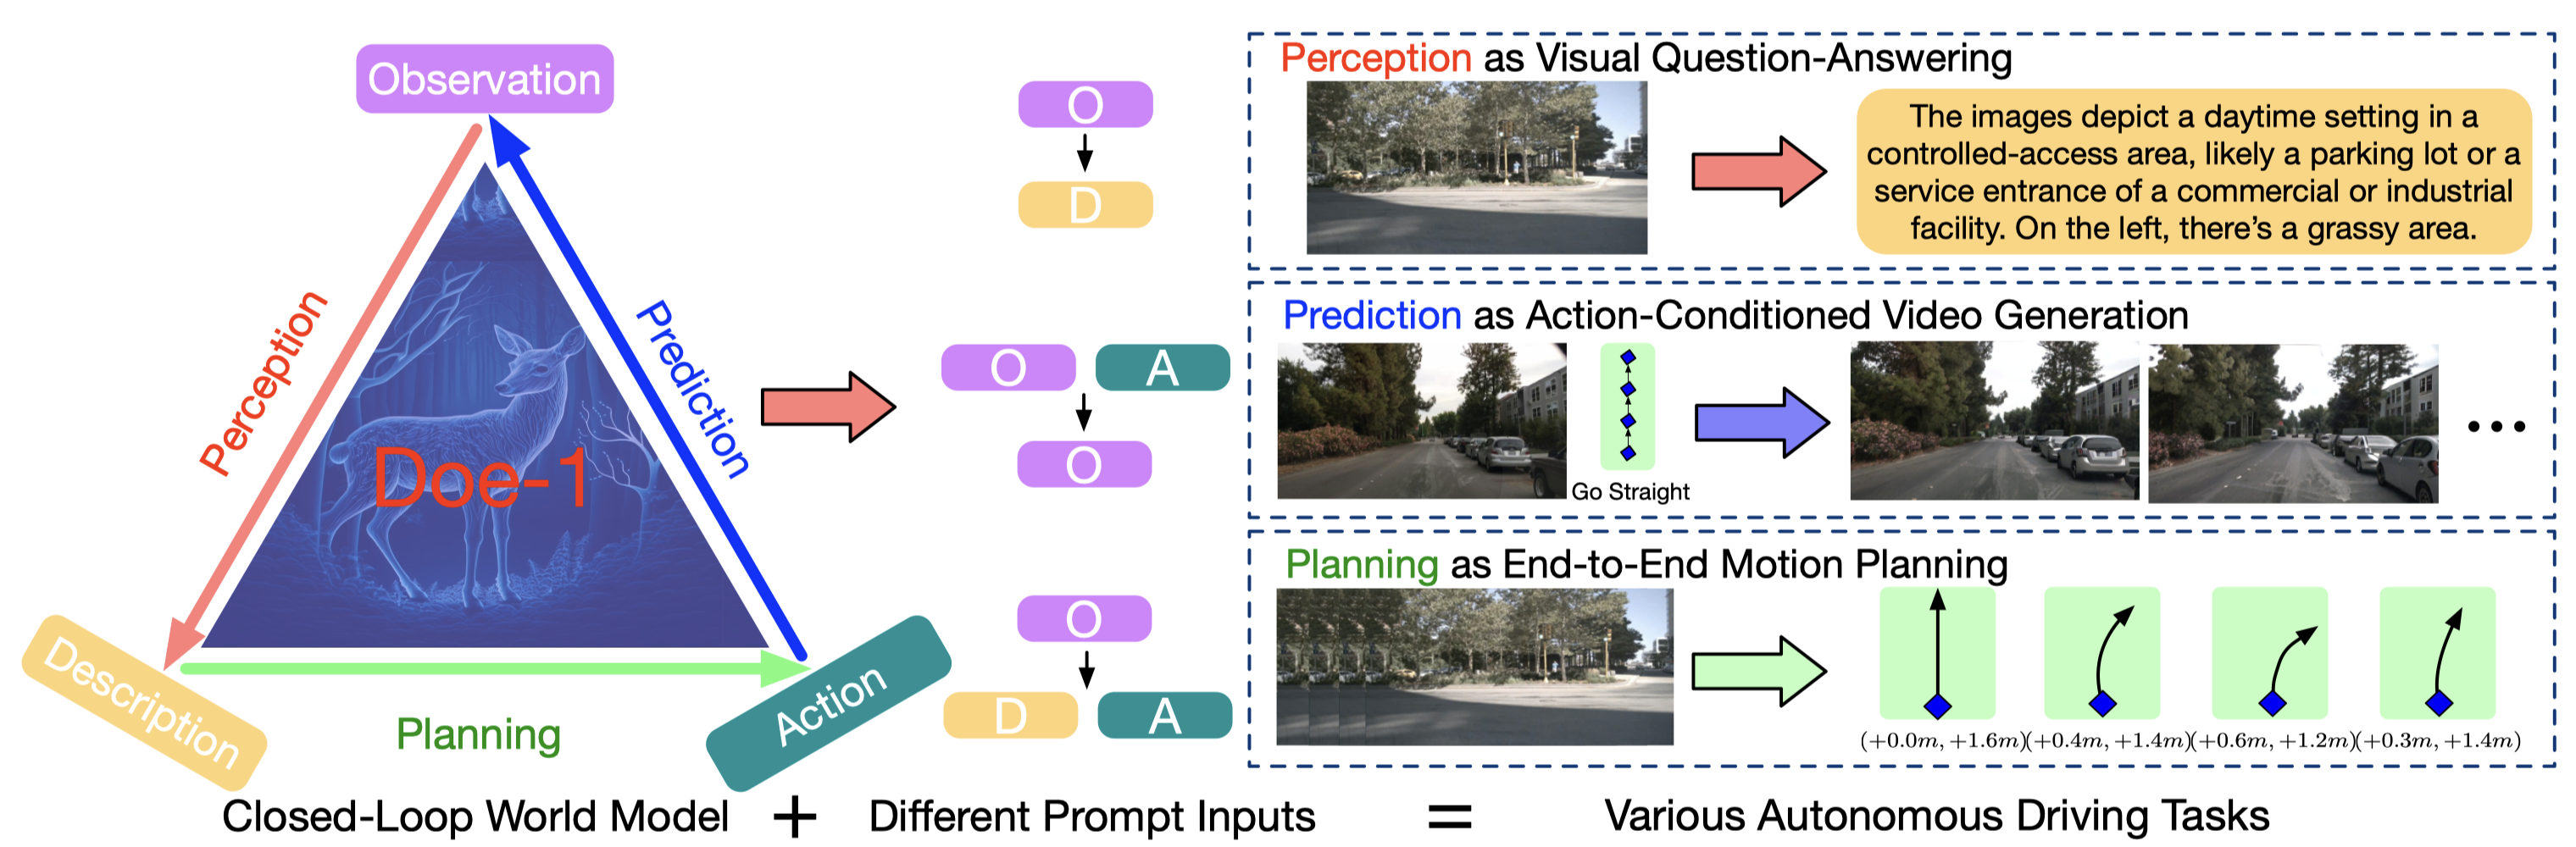
以未来预测、语言与视觉几何为依据,形成驾驶决策。
统一观测、描述和动作 token,支持视觉问答、未来生成与运动规划,探索驾驶模型和世界模型之间的闭环。
连接语言指令、行动计划与生成的未来观测,让同一场景能够响应不同的行为要求。
从自动驾驶拓展到人形机器人的通用移动与灵巧操作。
More coming soon
探索人形机器人的通用移动、全身协调,以及基于触觉的灵巧操作。
大模型与 AI 安全是物理超级智能(PSI)系统的共同技术基础。我们的研究从相似性度量学习与视觉表征开始,逐步发展到多模态大模型、空间智能体与AI内容鉴伪。
我们希望大模型成为 PSI Agent 连接感知、语言、推理与决策的认知核心。目前重点推进其中两项基础能力:高效多模态推理,以及在三维空间中的空间智能体。
More coming soon
我们正在探索多智能体进化与桌面智能体。
我们研究实现可靠、安全、友好 PSI Agent 的兜底机制。我们目前从生成内容验证切入:识别生成图像、发现生成视频中的伪造线索,并提供可供检查的证据。
More coming soon
我们希望从数字 AI 安全拓展到物理 AI 安全,从被动安全走向主动安全。
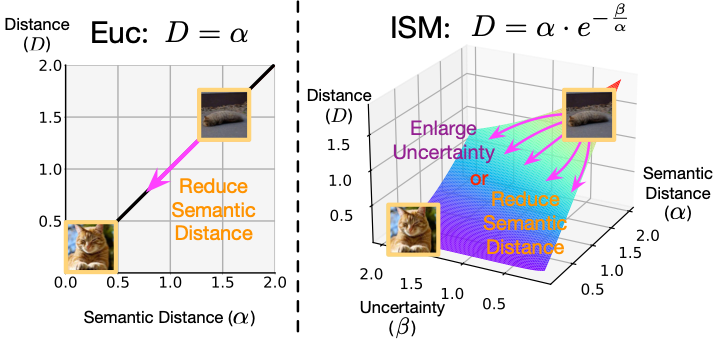
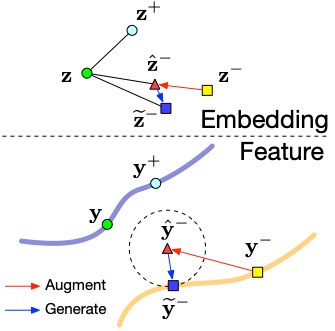
学习能够刻画结构、相似性与不确定性的表征。
早期度量学习工作通过生成难度自适应、标签保持的样本,探索训练样本如何塑造表示空间的几何结构。
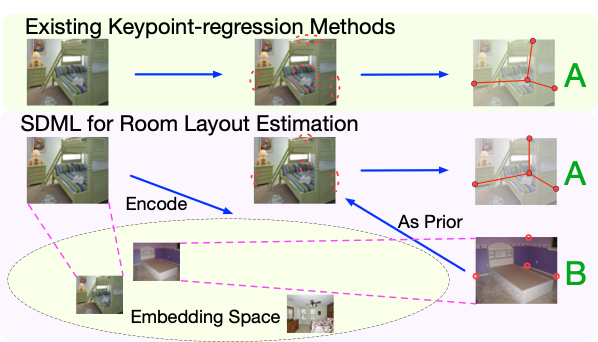
SDML 将图像与房间布局映射到共享空间,使距离反映结构差异,再解码得到场景布局。所列日期为出版社在线发表日期,尚未核实更早的预印本。
IDML 结合语义与不确定性嵌入进行图像比较。日期和引用数对应 2022 年原始预印本,扩展研究发表于 TPAMI 2024。
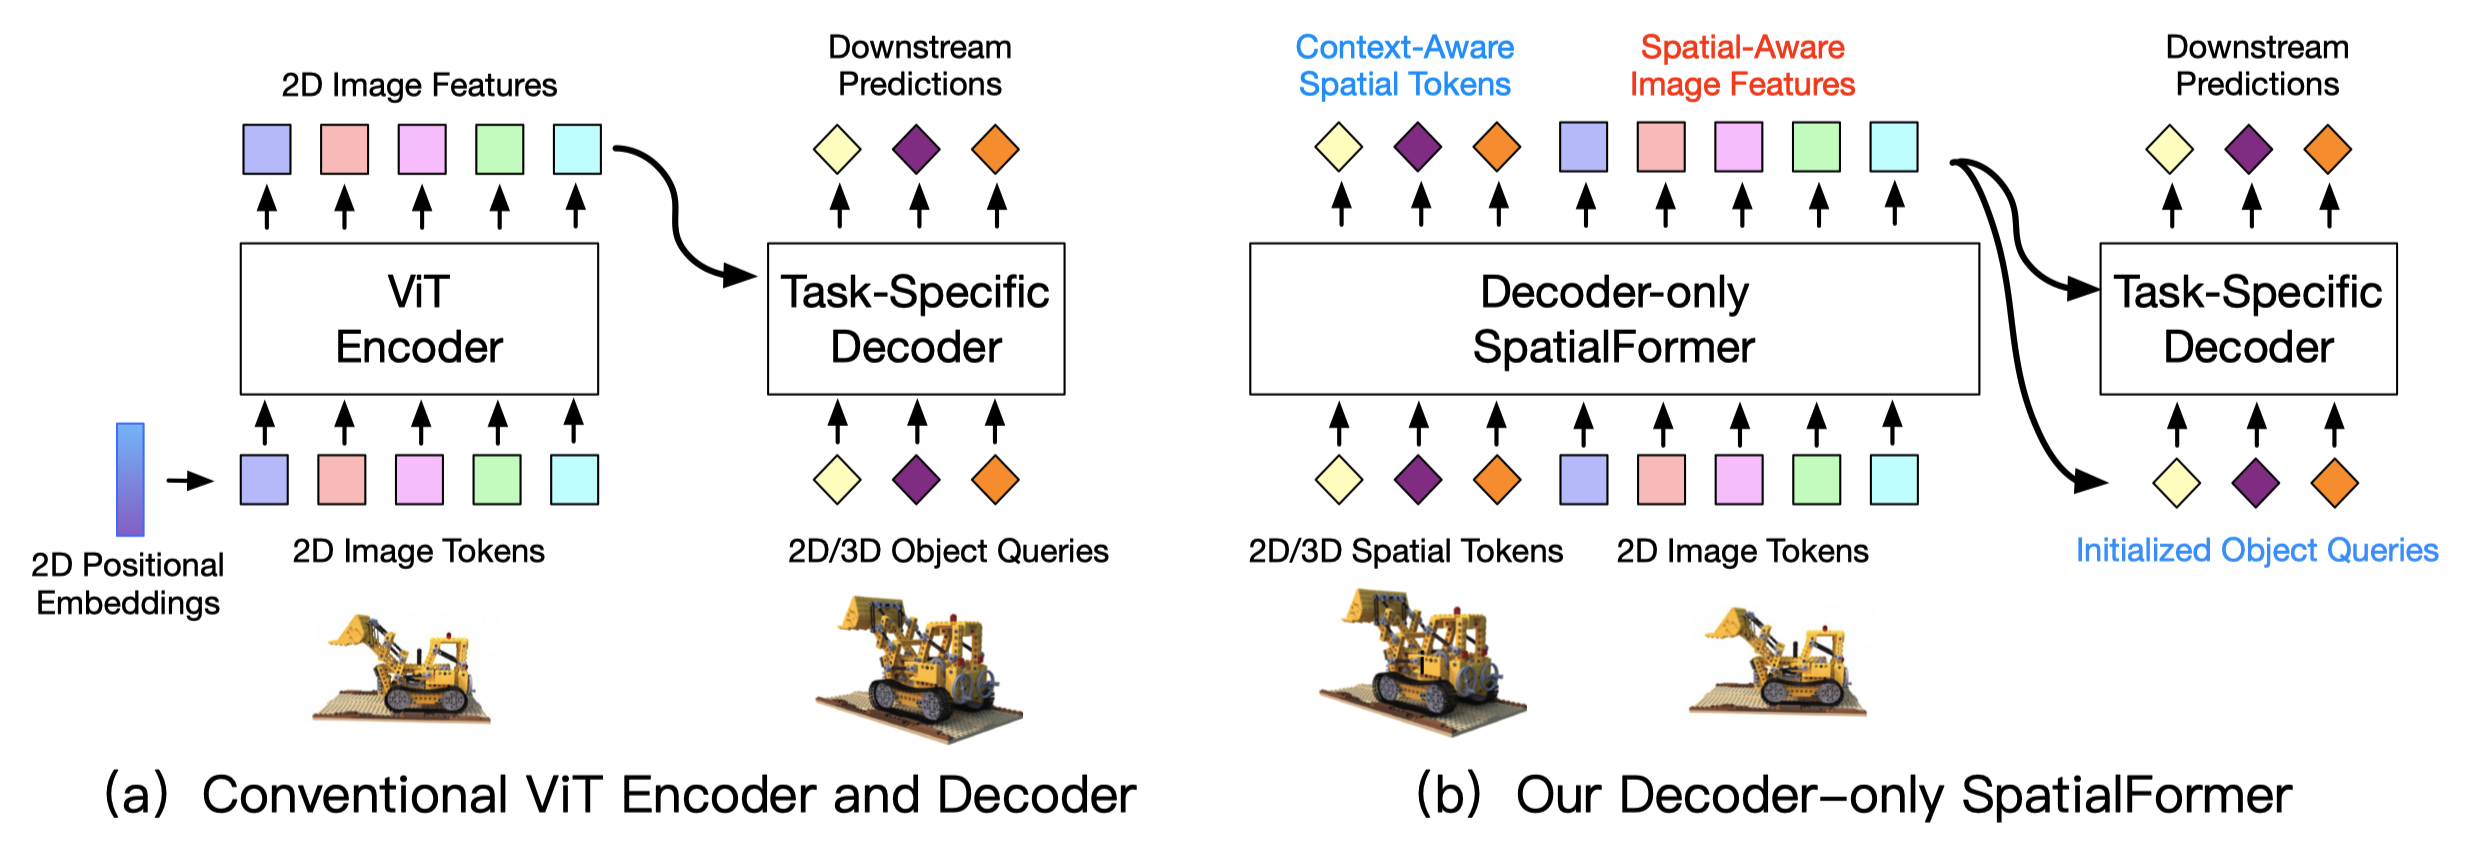
研究可迁移的视觉表征、监督方式与空间结构。
OPERA 将有监督与自监督学习纳入分层表征框架,探索不同监督信号如何共同促进可迁移的视觉特征学习。
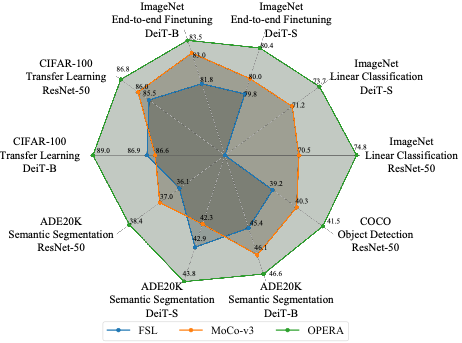
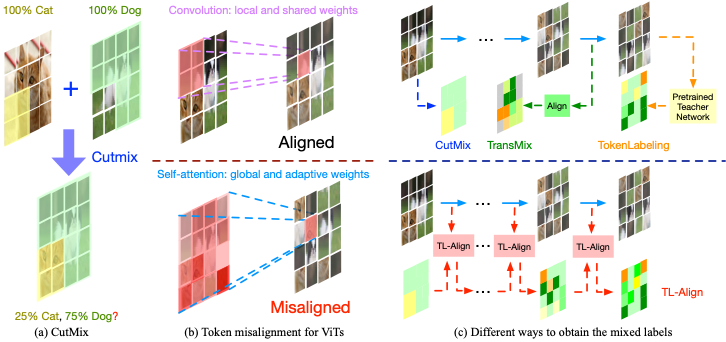
TL-Align 在为增强图像分配标签时考虑视觉 Transformer 中的 token 混合,使视觉证据与训练监督更加一致。
SpatialFormer 通过空间 token 与图像 token 的交互,学习可迁移的场景表征。所列日期为出版社在线发表日期,尚未核实更早的预印本。
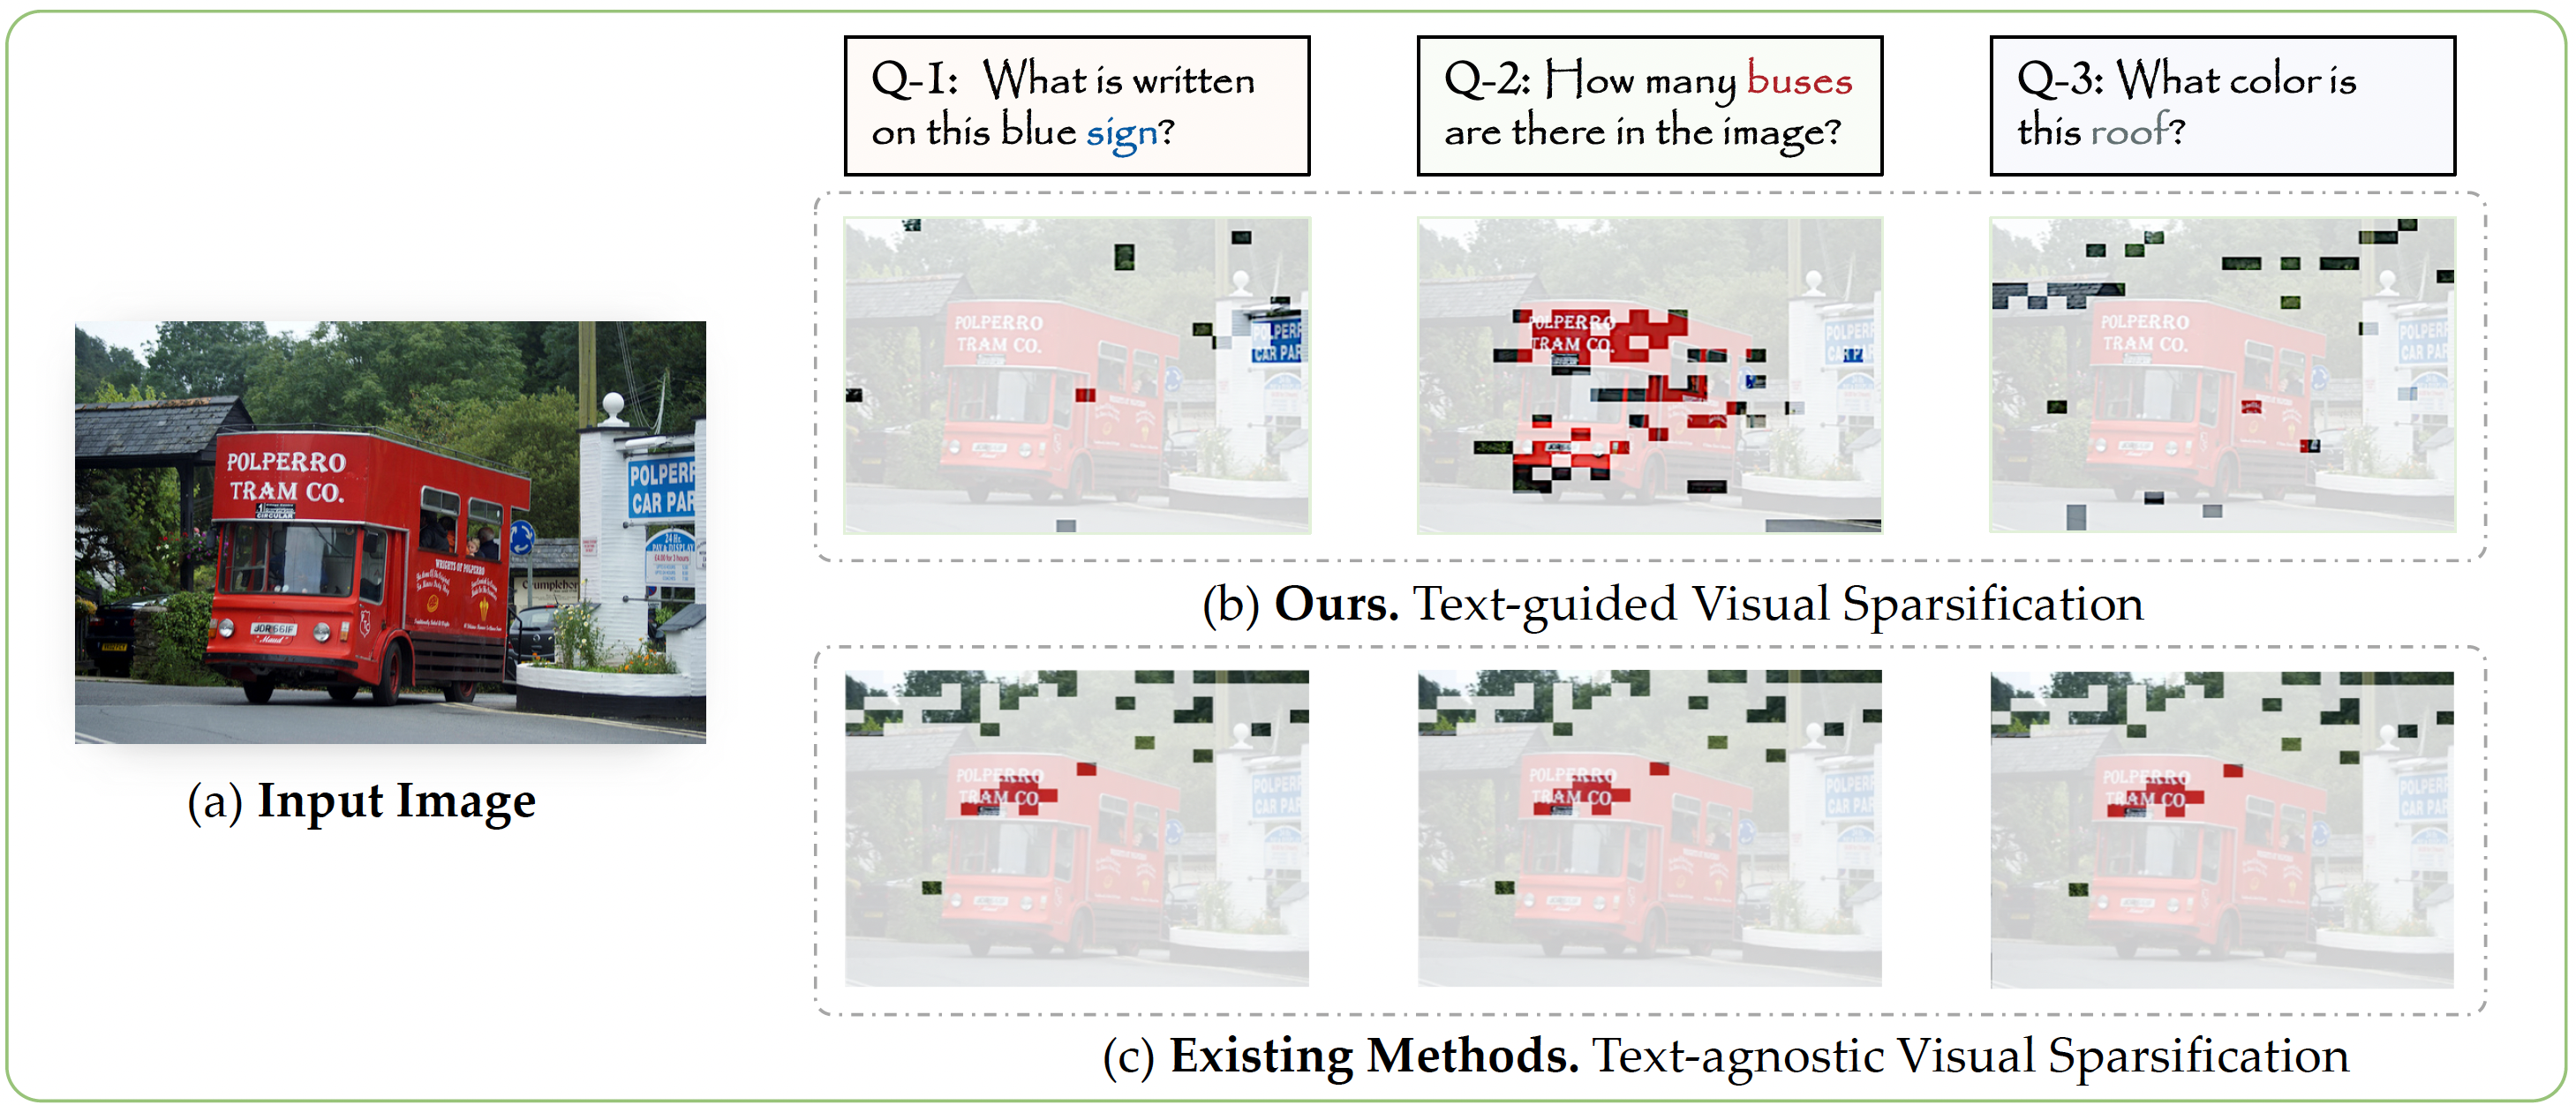
降低推理成本,同时保留与任务相关的视觉证据。
无需额外训练,通过文本引导的视觉 token 剪枝与回收,降低多模态推理成本,同时保留与问题相关的信息。
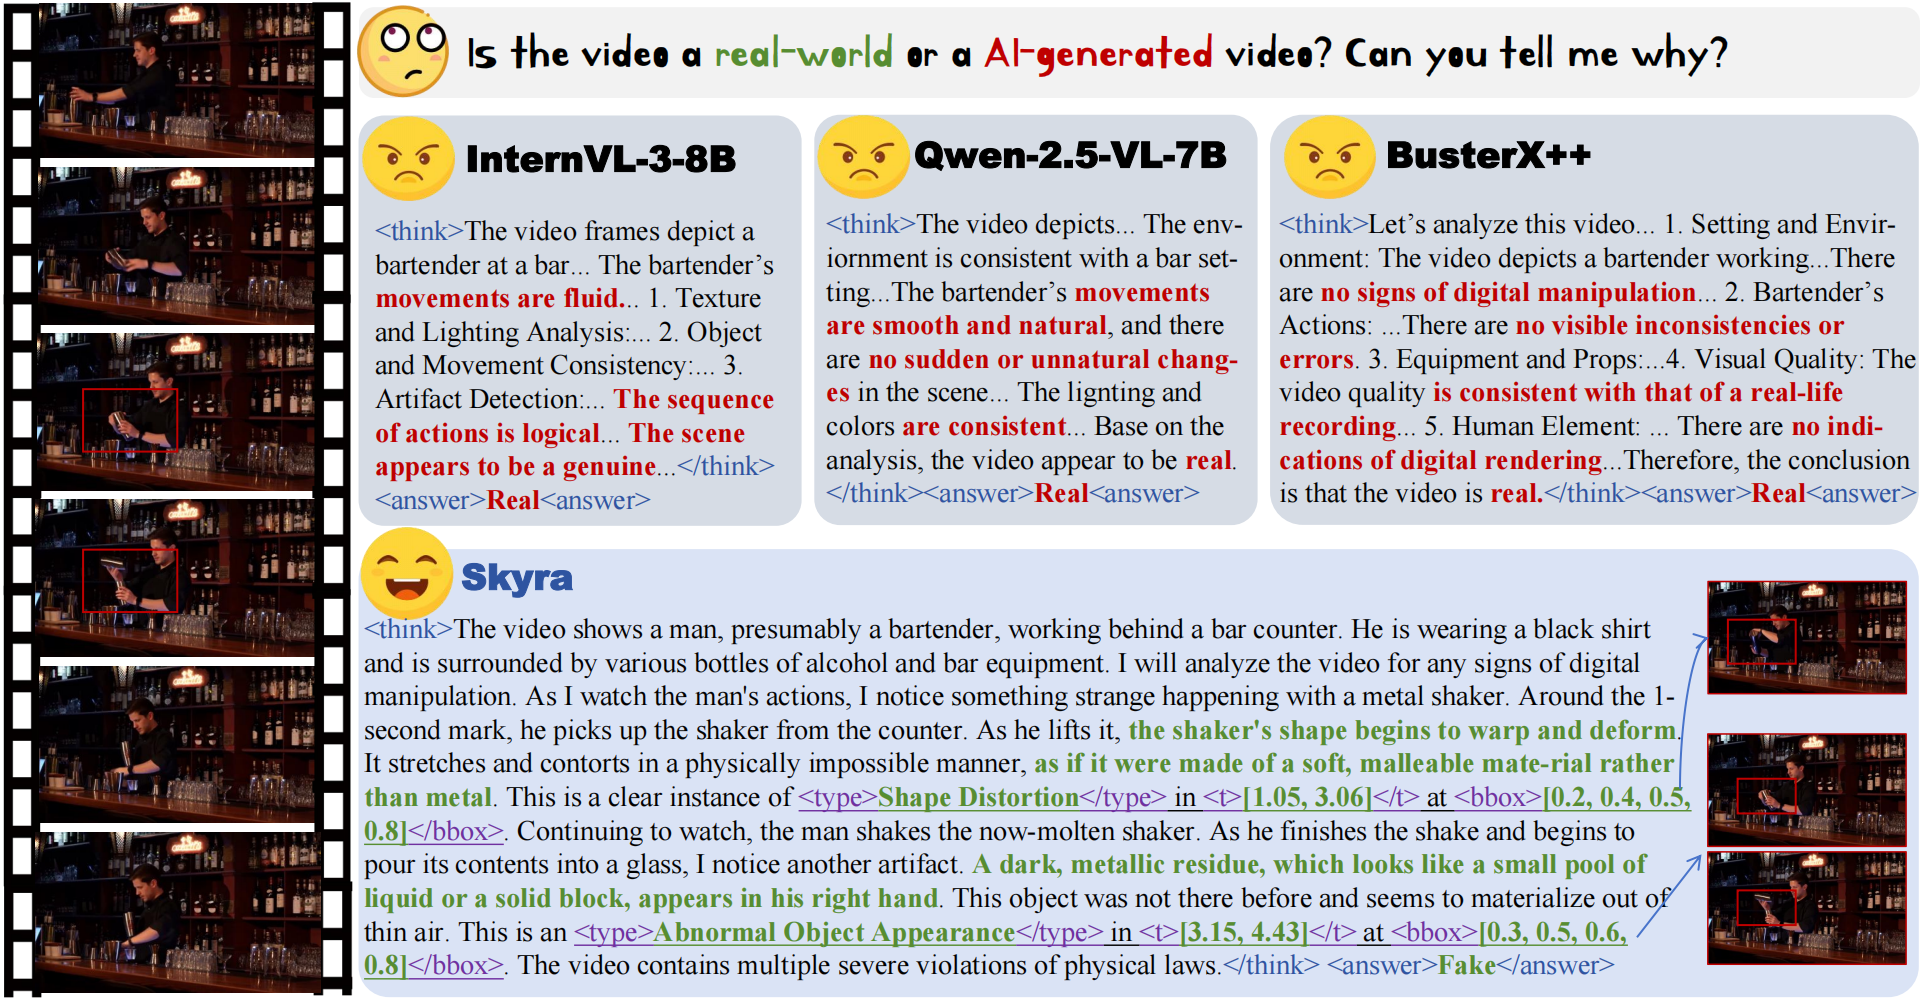
识别生成内容,并检查其中的时空不一致。
检测生成视频中人类可感知的瑕疵,将解释对应到具体区域与时间点,为内容验证提供证据,但不等同于物理 Agent 的安全保证。
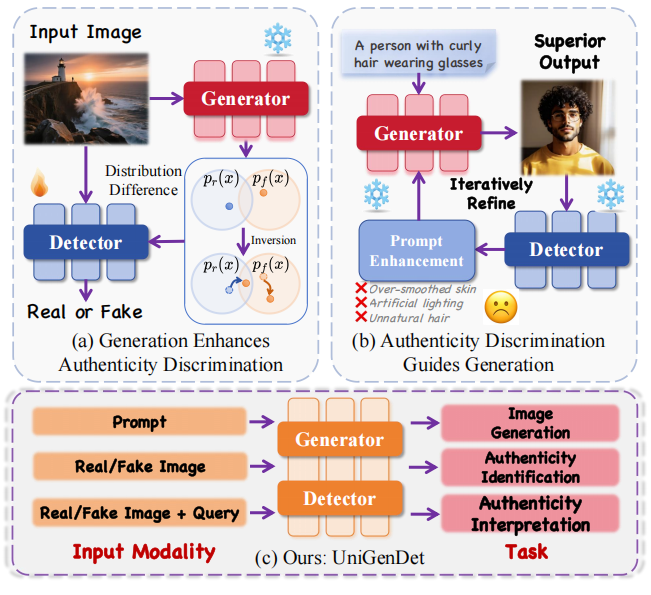
统一图像生成与生成图像检测,通过可解释的检测反馈改进生成,同时增强检测能力。研究聚焦生成内容分析,而非通用的 Agent 对齐。
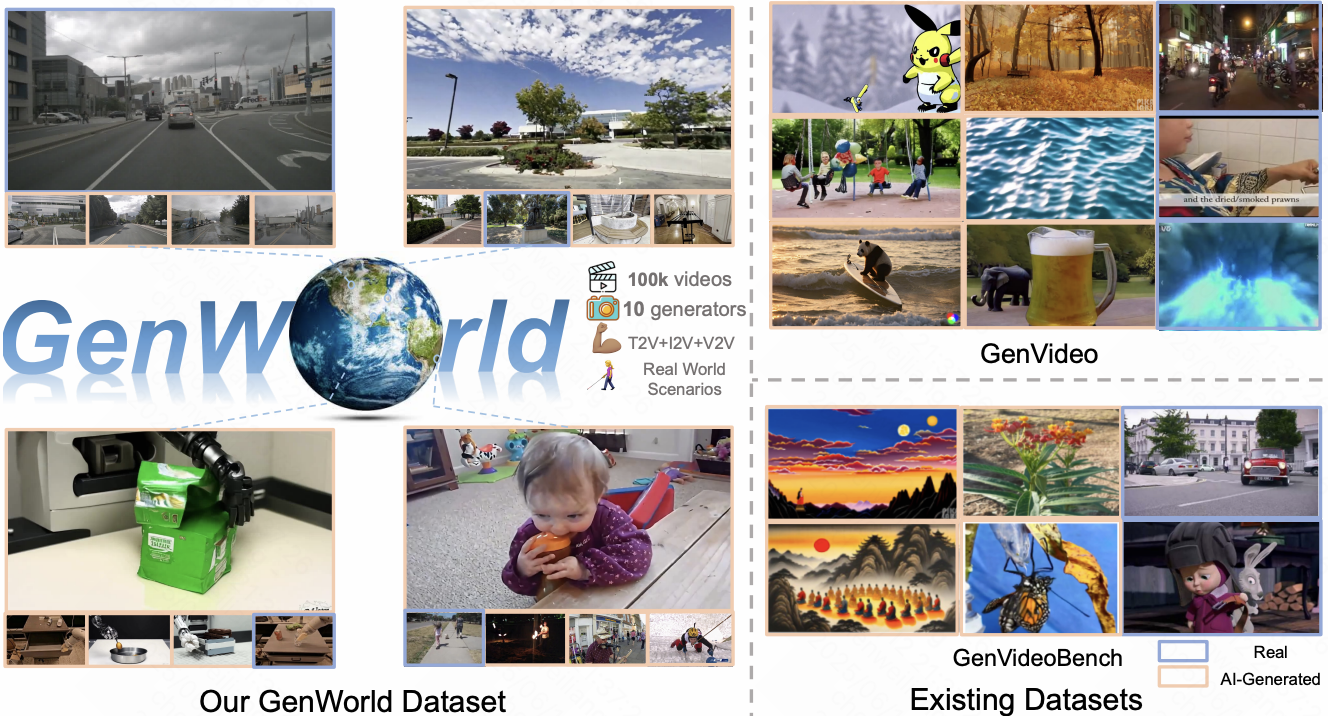
GenWorld 研究生成视频与真实世界观测之间的差异,通过基准数据与检测模型检验跨视角一致性,将内容鉴伪与物理真实性联系起来。
让大模型基于空间证据进行推理。
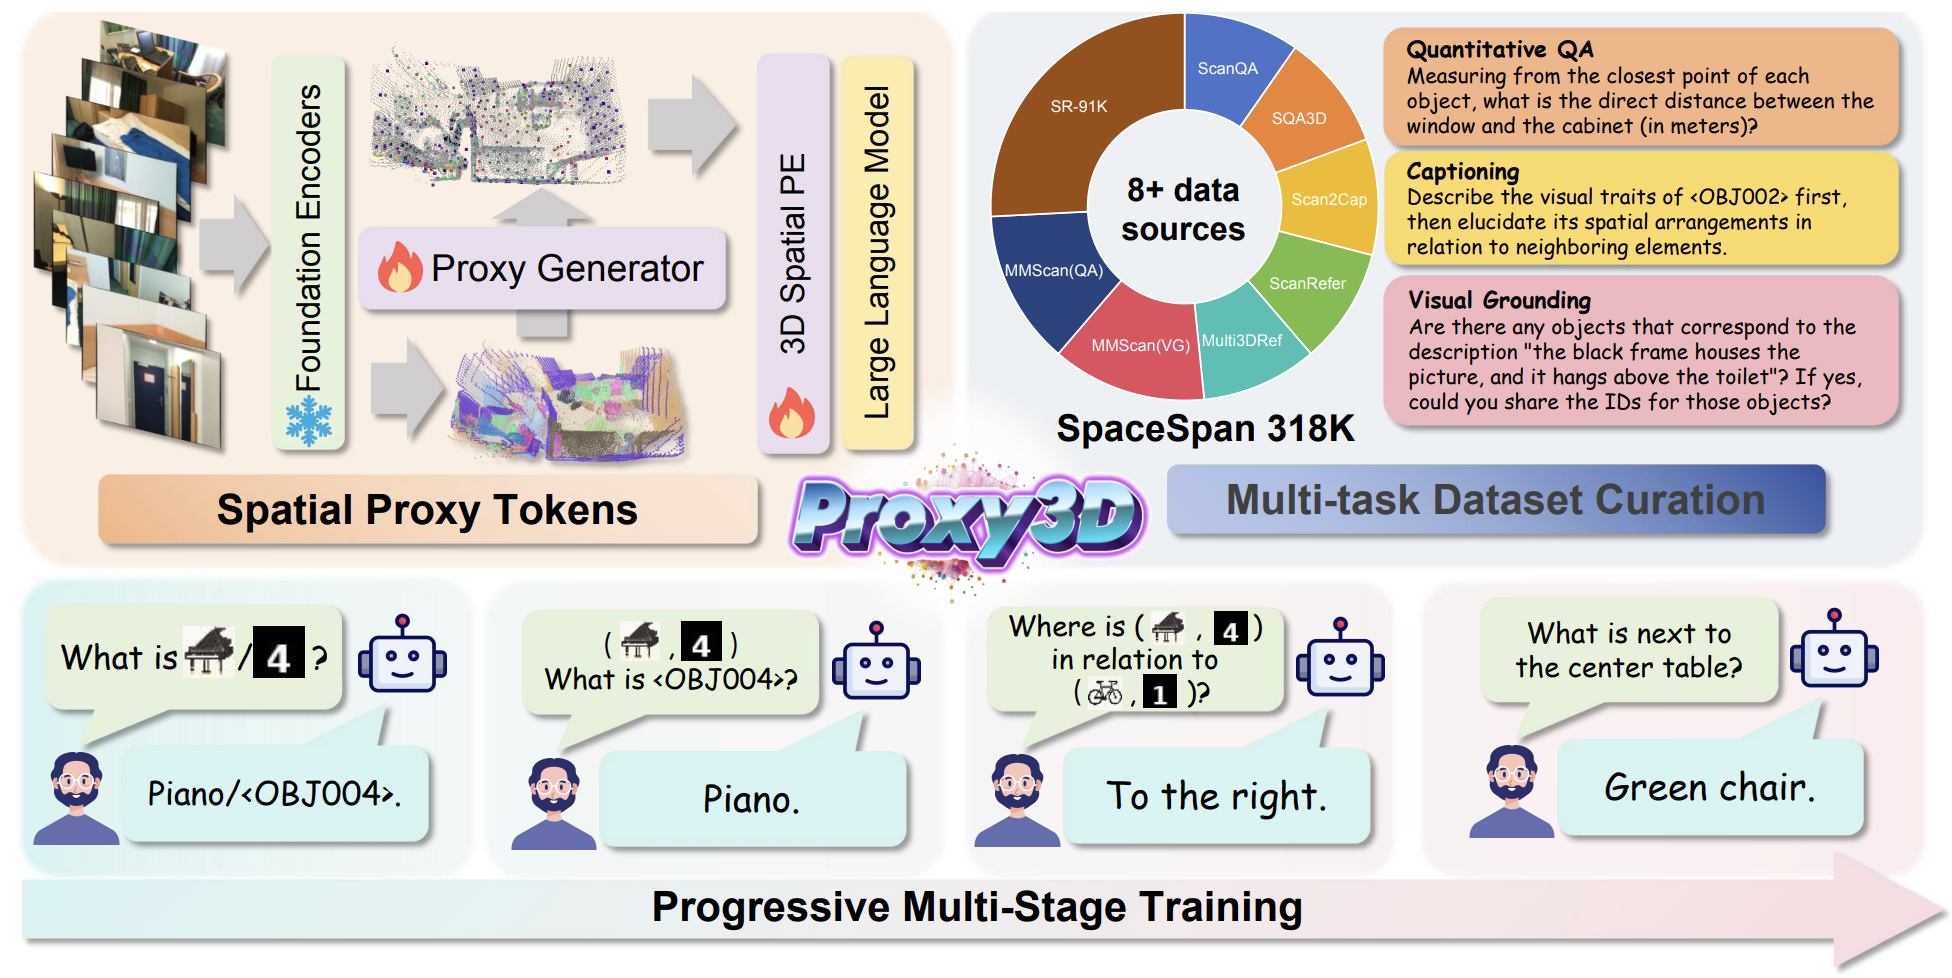
将语义聚类与几何特征组织为紧凑的三维代理表示,再与视觉语言模型对齐,用于空间问答和定位,为 Agent 提供空间推理所需的基础能力。
More coming soon
多智能体进化、桌面智能体。
我目前是加州大学伯克利分校电气工程与计算机科学系的博士后,隶属于 BAIR,合作导师为 Kurt Keutzer。我在清华大学获得自动化博士学位,导师为 Jie Zhou 和 Jiwen Lu,并在清华大学获得物理学学士学位。